chainhelen

mysql 踩坑记录

数字、字符串 如果mysql 里面 有数字字符串 的字段(并且该字段是索引),客户端不要直接传数字,一定要加引号 这个也就是为什么orm库喜欢在格式化时候,默认加上` 索引 索引的问题非常多,通常出现的慢查询都是由于查询语句命中索引不正确导致的 甚至表中的数据量都会影响mysql命中索引的规则 组合索引 组合索引是最左建立多个索引 in会命中索引,not in 会导致索引失效 排序最好主要范围语句会导致组合索引后续的索引失效(主要是 > < 等) 索引最终还是会回归到主键上,所以如果没有分区的情况下,是按照主键顺序返回的(InnoDB),这样基本也是利用来排序的 count 当然count要命中索引,这个不用说,剩余的就是 count(1) 不需要读太多数据,count(*)则不行 而count(column) 是需要筛选出不为 NULL 的字段 想到其他再更新
By chainhelen

旧服务优化思路

高可用 讲互联网的技术,不能不说高可用; 从某些书上面写的,主要通过“冗余+自动故障转”来实现的; 对于以下分层,每一层上面都使用上面两种方式: (1)【客户端层】到【反向代理层】 (2)【反向代理层】到【站点层】 (3)【站点层】到【服务层】 (4)【服务层】到【缓存层】 (5)【服务层】到【数据库读】 (6)【服务层】到【数据库写】 具体事例 记录一下具体实际工作中遇到一些烂项目,如何让它有基础的保障 下面的事例中主要是服务层、缓存层、数据库,其中几处分类是有一定的重叠的 1. 监控 服务本身除了提供基本的 api 延迟、qps、状态码统计,还需要加上对于依赖的监控 主要核心的监控数据包含以下

By chainhelen

dlv

dlv 源码阅读

一. 目录介绍 1._fixtures 这个文件夹下面主要放一些用于测试的应用程序源码 2.assets 存放了4个代表delve的图标 3.cmd 这个是server/client的命令行入口 主要从commands.go这个文件体现,主要使用spf13/cobra来做命令行工具(相信喜欢使用vim的人都应该听过spf13) 主要命令有debug、trace、attach等,但是这些命令核心都是在使用gobuild、execute,所以基本看这两个函数即可 gobuild 主要是对需要调试源码的进行编译 execute 主要是对已经编译好的二进制进行运行、attach,用于调试(已经运行的进程,就直接attach) 4.Documentation 主要放dlv的文档,另外关于cmd的文档都是通过script/gen-usage-docs.go生成的 就是说大部分都是cmd目录的help注释 5.service service入口是/service/rpccommon/server.go,主要是由cmd来调用server的Run()、Close(

By chainhelen

记一次openrestry问题

背景 团队所做的微服务,统一签名校验是在openrestry(nginx)的lua脚本计算的 突然有人报告了一个bug,当post请求body大于10k的时候,签名就会失效 原因 在读取body参数时候,使用ngx.req.get_body_data This function returns nil if 1. the request body has not been read, 2. the request body has been read into disk temporary files, 3. or the request body has zero size. 很明显是命中了第二条,body太大,会被存储到临时文件,

By chainhelen

go

snowflake

分布式Id snowflake 是一种分布式id唯一算法,相比较uuid算法生成方式,snowflake生成的是一个int64大整型,并且是大致递增 我发现网上对于该算法的描述,在位数偏移上是由差异的,但是整体思路是一致的 这里的10-bit workerId在有的源码里面是分成两个 workerId 、data的5-bit大小 可以大致算一下,1毫秒1单点能生成2 ^ 12 = 4096个id,总共能部署 2 ^ 10 = 1024 个节点,也就是1毫秒最大能生成400多万个id 我按照算法思路写了如下代码 package main import ( "errors" "fmt" "sync" "time" ) var ( // 1288834974657 是 (Thu, 04 Nov 2010 01:42:

By chainhelen
误用gorm引起的一宗血案

mysql

误用gorm引起的一宗血案

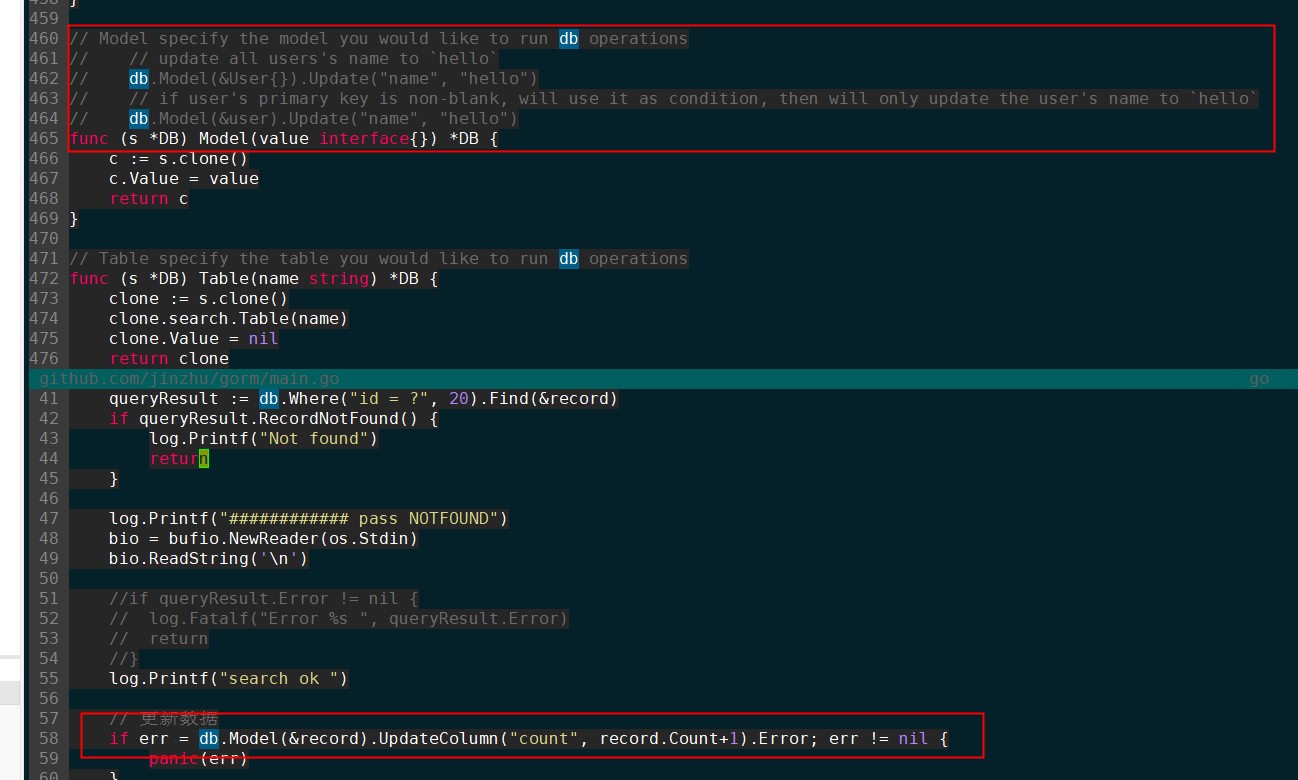
现象 某服务A从晚上6点开始,监控一直出现mysql调用延迟超高,http接口500飙升 原因 经查发现是一条全局update整张表的sql引起的,全局lock表 最小化 使用下面操作进行最小化 建库 create databses test; 建表 CREATE TABLE `Record` ( `id` BIGINT NOT NULL, `count` BIGINT NOT NULL, PRIMARY KEY(`id`) ) ENGINE = InnoDB; 插入一条数据 CREATE TABLE `Record` ( `id` BIGINT NOT NULL, `count` BIGINT NOT NULL, PRIMARY KEY(`id`) ) ENGINE = InnoDB; 代码如下: package main

By chainhelen

锁

关于锁的总结(三)信号量

难点 个人感觉信号量主要难在应用场景上; 同等对比,互斥量主要用来上锁,条件变量来优化多任务等待 其中互斥量正常场景下,都应该(最好都是遵从这样方式)保持上锁、解锁是同一个task; 在《评论迁移》里面,分布式锁redis的set NX 过程中,参数是key、requireId、expiration,其中requireId(多task环境下唯一ID)就是为了保证上锁、解锁是同一个task 综合来看,好像不需要信号量这类东西的存在 《UNIX 网络编程 卷2:进程间通信》 一书上讲了互斥量、信号量、条件变量的区别 (1)互斥锁必须总是由给它上锁的的线程(任务)解锁,信号量的挂出却不必由执行过它的等待操作的同一线程执行。(这是个特性,实际测试中go语言中的互斥量其实是可以的)。 (2)互斥锁要么被锁住,要么被解开(二值状态,类似于二值信号量)。 (3)既然信号量有一个与之关联的状态(它的计数值),那么信号量挂出操作总是被记住。然后 PV操作

By chainhelen