chainhelen

落盘的b+树

参考内容 项目地址: bptree 代码参考:主要参考了两个版本bplustree和go的内存版本bptree   定义参考:对于b+树的定义有太多了,主要参考了b+树总结 实现细节 1. 可以提前申请一些节点(leaf和node)结构的内存池,避免大量内存申请和释放 2. 每个磁盘块(系统和磁盘交互的最小逻辑单位)都是一个节点所占空间大小(会有浪费),需要序列化写入文件 3. 因为是递归操作,所以每一个函数当出现将某块磁盘节点映射成内存节点,都应该在函数结束前某个时机(可能其他调用了其他递归函数也进行了映射,造成数据覆盖)刷盘 4. 文件开始位置并不一定是根节点,因为节点会不断增加和删减,所以在读取文件时候需要check root   5. 还有一些事务性问题,比方当前节点已经刷盘,但是延伸更新父亲节点刷盘失败,这种情况暂时没有考虑   b+树优
By chainhelen

go

godbg 介绍

Start a new project, the debugger on linux platform for go. This project is inspired by dlv github地址 背景 没想到这个项目最终还是沦为为一个玩具。初次有这个想法是因为发现 gdb调试golang代码是可以进入runtime的指令,而dlv却不可以。例如像map这种的初始化 s := make(map[int]string, 20) 主要是dlv将runtime的代码都skip掉了,表示对golanger无需关心底层的逻辑,只需要关心自己编写的代码即可。 先看一下效果 实现 代码本身分为5个步骤,代码是在main.go 1. 获取生成含.debug可执行文件的路径 2. 编译创建可执行文件 3. 分析可执行文件里面的_zdebug的字段,以便后续调试使用 4. 执行可执行文件,并且ptrace

By chainhelen

nsq

nsq 支持分布式事务(四)

也许我就是个跑偏的人,这个系列越写越偏 基准测试 本来是跟原版里面./bench.sh做一些基准测试,在我这台垃圾电脑上面 写性能 最后发现如果没有SyncTimout(就是超时落盘)这个,dtnsq写竟然40w/s,而nsq才18w/s~20w/s 没办法加上了默认了SyncTimout(2s),但是dtnsq也是30w/s 大家在落盘之前都是内存操作,如果有性能差异,我猜测是 channel导致的 读性能 读性能没法比较,因为当前dtnsq根本没有做push,只是定时拉取 修改 我需要将一些代码细节优化(不是为了写性能),稍微向生产方向靠近再来进一步测试 优化定时器 之前的消费者的pull定时器是从nsqd里面触发的,很容易将整个nsqd``lock住 这里面改成每一个读backend自行维护一个定时器 控制反转 之前写代码的时候,有考虑一些控制反转,但是还需要细致下去,主要是为了做单元测试 不然现在改几行根本不敢确定有没有影响之前的功能 (未完待续)

By chainhelen

go

go源码阅读 slice

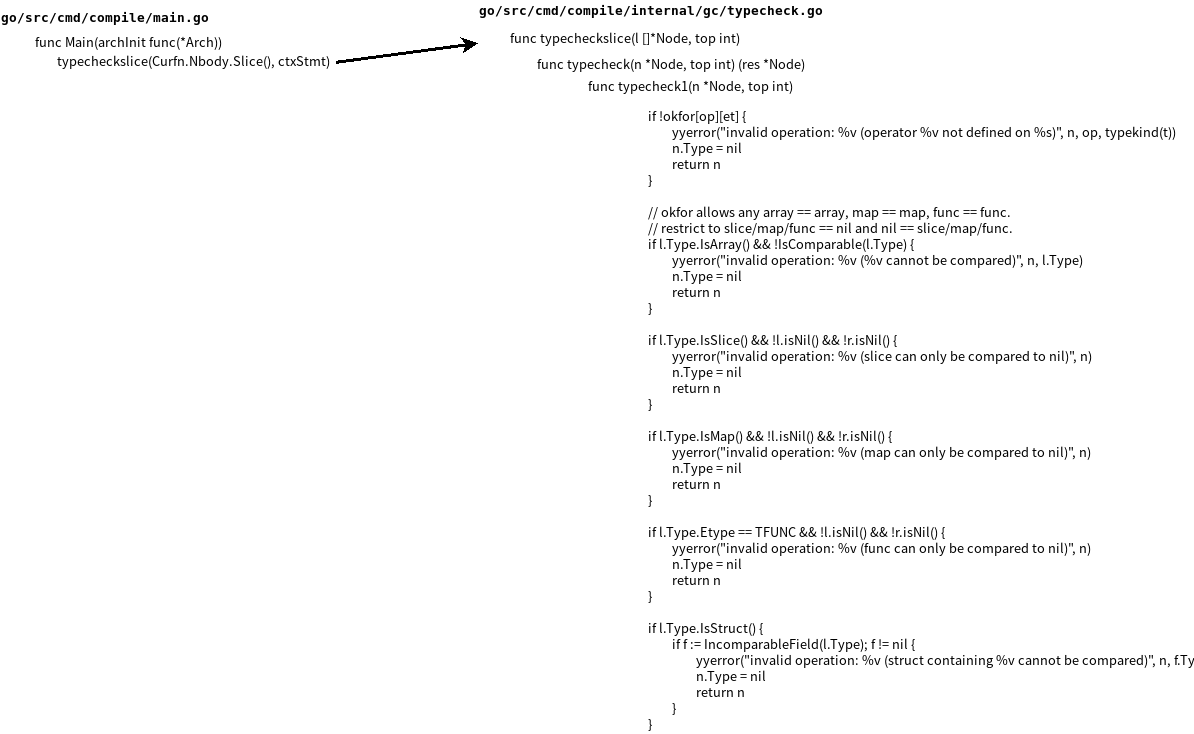
slice 对于slice来说,其实源码部分并不多,主要看一下make slice、growslice、slicecopy和copy 编译阶段 make slice语句跟map一样,在compile的typecheck阶段,将MAKE节点偷偷换成OMAKESLICE节点 关于oppend的代码实在/usr/local/go/src/cmd/compile/internal/gc/ssa.go的func (s *state) append(n *Node, inplace bool) ,这个是编译时代码 关于slice的代码在/usr/local/go/src/runtime/slice.go ,这部分是运行时代码 type slice struct type slice struct { array unsafe.Pointer len

By chainhelen

go

go源码阅读 defer

defer 这个话题有点大,只是翻阅了关键代码,细节太多了 主要defer要弄明白两个函数,函数目录在/usr/local/go/src/runtime/panic.go中的deferproc和deferreturn deferproc //主要这里面都不能使用栈分裂,不能进行逃逸分析,因为defer是希望利用栈内存处理 //go:nosplit func deferproc(siz int32, fn *funcval) { ... d := newdefer(siz) // 最核心的就是这里 ... } // 核心新建defer的逻辑 func newdefer(siz int32) *_defer { //获取当前协程 gp := getg()  ... // 这中间主要优化defer内存逻辑,看能不能复用 // 如果d==nil,说明上面没有获取有效大小,需要创建 if d == nil { // 分配defer和其args的内存 systemstack(func(

By chainhelen
go源码阅读 map

go

go源码阅读 map

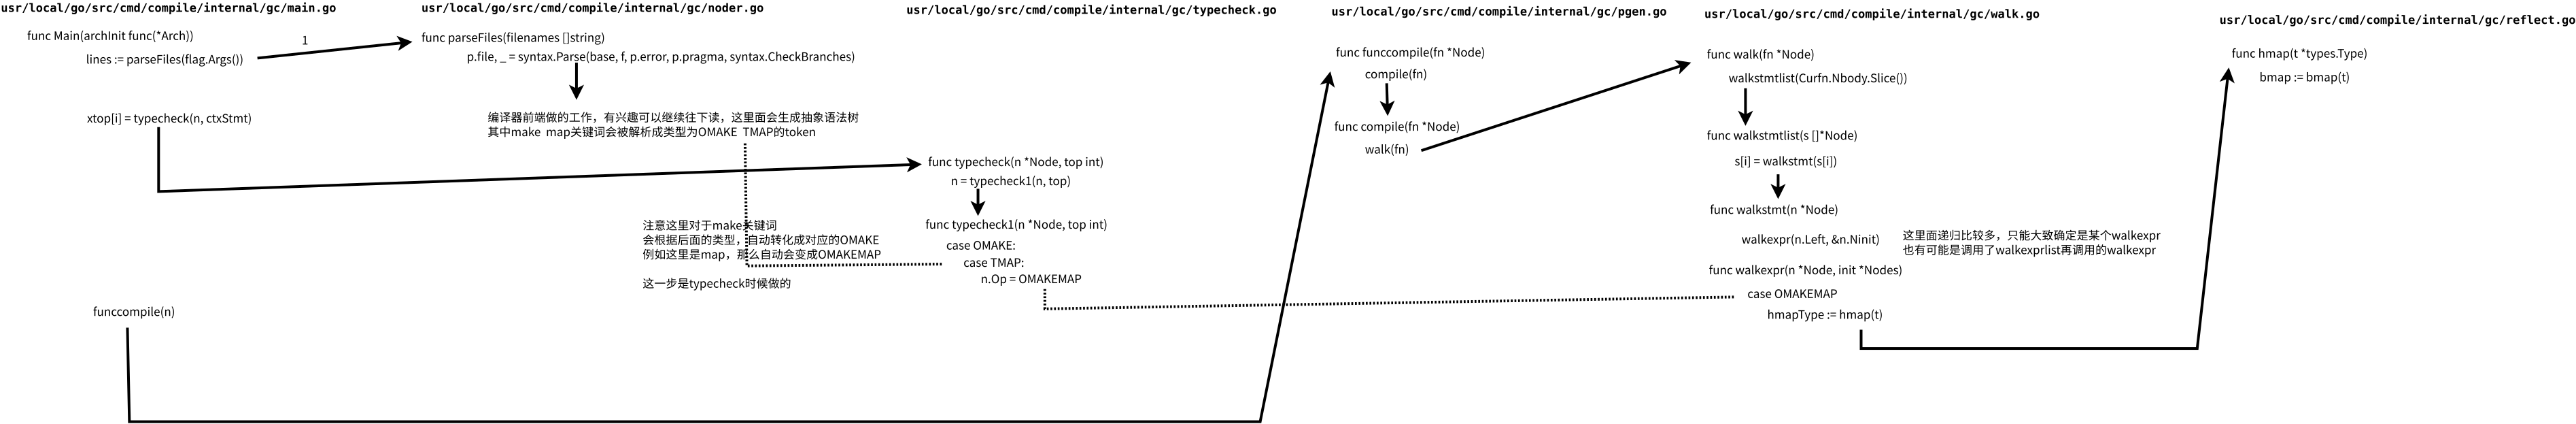
序 关于map的实现,我按照我的思路来看源码,中间尝试了挺多的case,最终选了一些来作为实例 可能跟网上其他人不太一样  准备工作 首先做一些准备工作,跳过一下与编译无关的过程,例如搜索依赖关系    1. 样例代码 新建临时目录test_map,在该目录下写入样例代码 // main.go package main import ( "fmt" ) func test_map() { s := make(map[string]int, 3) s["chainhelen1"] = 1000 s["chainhelen2"] = 2000 s["chainhelen3"] = 3000 fmt.Printf("

By chainhelen

一道变量compare题的延伸

我遇到的问题是第4道例子,建议读者先不要看答案,因为代码本身非常简单。 先下载题目,看看一共5道例子能不能完全做对,这样看到答案的时候会感到更有趣。   判断下面的例子, a和b是否相等 例子一 // compare_1.c #include <stdio.h> int main() { char a[11] = "helloworld"; char b[11] = "helloworld"; if (a == b) { printf("equal\n"); } else { printf("not equal\n"); } return 0; } 答案是not equal,

By chainhelen

go

nsq 支持分布式事务(三)

主备同步 代码提交记录 完成度 只完成了主从复制;但是主备切换、依据处理能力动态调整消费能力、一些write失败逻辑处理 没有完成 基本逻辑 数据 主要分成了三部分数据的复制 1. 发送SLAVE_SYNC_INFO命令,返回所有的topic和其对应的channel 2. 发送SLAVE topic_name命令,携带当前topic的关键4个参数fileindex filenum totalMsgCnt viroffset和一个maxnum希望本次同步返回的消息数量,返回 master的关键参数和消息本身 3. 发送SLAVE topic_name channel_name,携带当前的4个关键参数,返回master的关键参数 客户端请求 对于slave是不可以接受普通client的请求的 ,连接master复用了master与client的 tcp端口 同步 or 异步 一开始写了一个同步版本,就是slave每次发送SLAVE消息,就等待结果 后来改成了异步发送,异步里面主要需要做大量的check避免时序问题,造成SYNC数据错乱问题

By chainhelen

nsq

nsq 支持分布式事务(二)

核心代码逻辑 commit 修改dtpre队列 在考虑落盘之前,先思考另一个问题,由于dtpre本身跟消费者无关,只跟生产者有关,其实并不需要等到消息从topic分发到各个channel里之后再进行commit(cacel),浪费存储空间(如果落盘就浪费了磁盘空间) 所以我们将dtpre的部分移至topic中存储 落盘逻辑 对于落盘逻辑来说,不只是dtpre的逻辑需要修改,如此对于一般的消息来说,都应该进行落盘 而channel来说只需要落盘数据索引即可 修改细节 实际这次提交修改了比较多的内容,最核心的还是移除了memoryMsgChan(无论是 topic 还是 channel),添加了backendMsgChan. 读写轮盘在于 1. nsqd/diskqueue_reader.go 采用了定时器pull方式,而不是之前的push方式 这个地方可能存在性能问题,因为每次是拉去tryReadOne的方式 2. nsqd/diskqueue_writer.go 里面writeOne函数,其实没有写入磁盘,而是写入了一个buffer(注意对于roc

By chainhelen