最新

go

go源码阅读 defer

defer 这个话题有点大,只是翻阅了关键代码,细节太多了 主要defer要弄明白两个函数,函数目录在/usr/local/go/src/runtime/panic.go中的deferproc和deferreturn deferproc //主要这里面都不能使用栈分裂,不能进行逃逸分析,因为defer是希望利用栈内存处理 //go:nosplit func deferproc(siz int32, fn *funcval) { ... d := newdefer(siz) // 最核心的就是这里 ... } // 核心新建defer的逻辑 func newdefer(siz int32) *_defer { //获取当前协程 gp := getg()  ... // 这中间主要优化defer内存逻辑,看能不能复用 // 如果d==nil,说明上面没有获取有效大小,需要创建 if d == nil { // 分配defer和其args的内存 systemstack(func(
By chainhelen
go源码阅读 map

go

go源码阅读 map

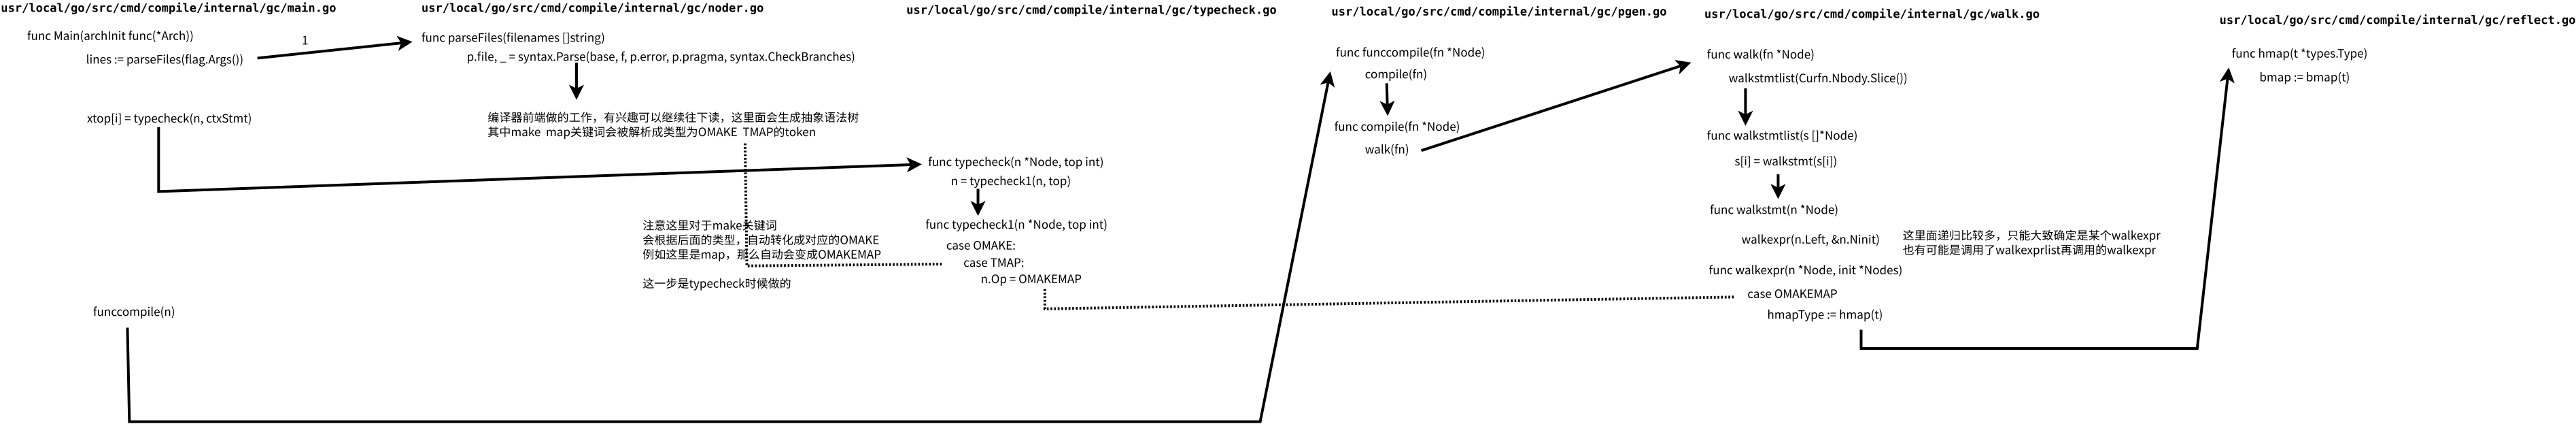
序 关于map的实现,我按照我的思路来看源码,中间尝试了挺多的case,最终选了一些来作为实例 可能跟网上其他人不太一样  准备工作 首先做一些准备工作,跳过一下与编译无关的过程,例如搜索依赖关系    1. 样例代码 新建临时目录test_map,在该目录下写入样例代码 // main.go package main import ( "fmt" ) func test_map() { s := make(map[string]int, 3) s["chainhelen1"] = 1000 s["chainhelen2"] = 2000 s["chainhelen3"] = 3000 fmt.Printf("

By chainhelen

一道变量compare题的延伸

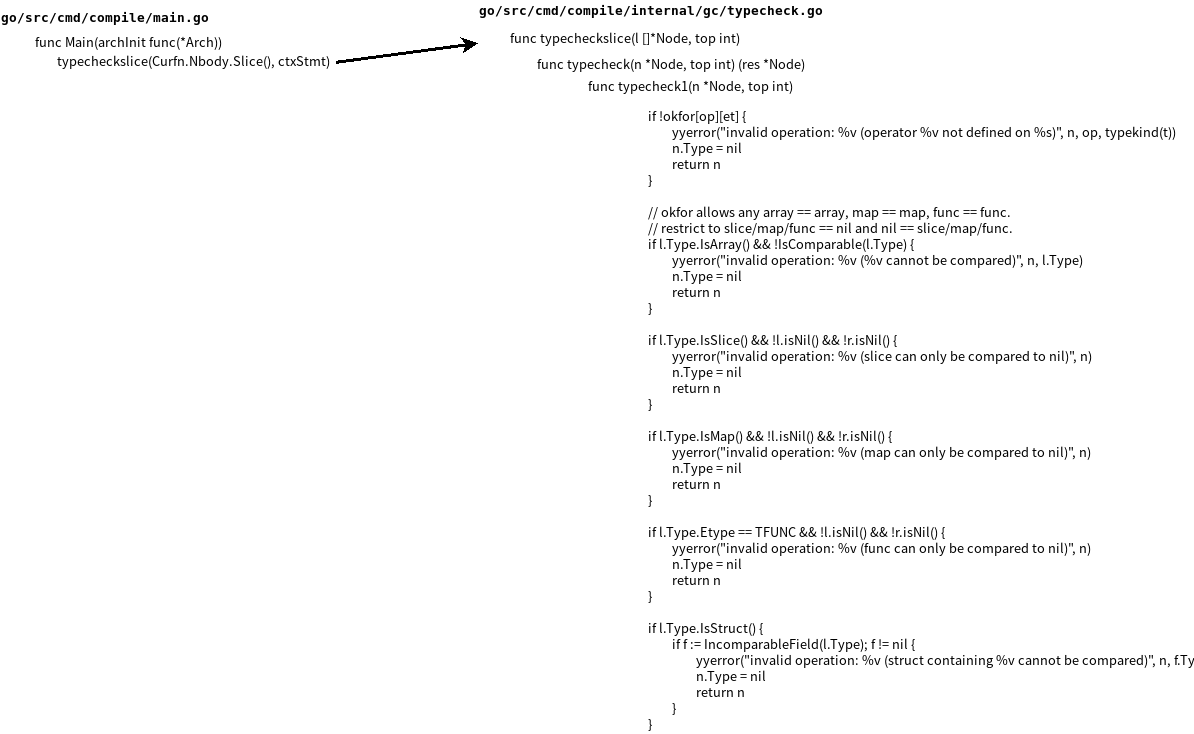
我遇到的问题是第4道例子,建议读者先不要看答案,因为代码本身非常简单。 先下载题目,看看一共5道例子能不能完全做对,这样看到答案的时候会感到更有趣。   判断下面的例子, a和b是否相等 例子一 // compare_1.c #include <stdio.h> int main() { char a[11] = "helloworld"; char b[11] = "helloworld"; if (a == b) { printf("equal\n"); } else { printf("not equal\n"); } return 0; } 答案是not equal,

By chainhelen

go

nsq 支持分布式事务(三)

主备同步 代码提交记录 完成度 只完成了主从复制;但是主备切换、依据处理能力动态调整消费能力、一些write失败逻辑处理 没有完成 基本逻辑 数据 主要分成了三部分数据的复制 1. 发送SLAVE_SYNC_INFO命令,返回所有的topic和其对应的channel 2. 发送SLAVE topic_name命令,携带当前topic的关键4个参数fileindex filenum totalMsgCnt viroffset和一个maxnum希望本次同步返回的消息数量,返回 master的关键参数和消息本身 3. 发送SLAVE topic_name channel_name,携带当前的4个关键参数,返回master的关键参数 客户端请求 对于slave是不可以接受普通client的请求的 ,连接master复用了master与client的 tcp端口 同步 or 异步 一开始写了一个同步版本,就是slave每次发送SLAVE消息,就等待结果 后来改成了异步发送,异步里面主要需要做大量的check避免时序问题,造成SYNC数据错乱问题

By chainhelen

nsq

nsq 支持分布式事务(二)

核心代码逻辑 commit 修改dtpre队列 在考虑落盘之前,先思考另一个问题,由于dtpre本身跟消费者无关,只跟生产者有关,其实并不需要等到消息从topic分发到各个channel里之后再进行commit(cacel),浪费存储空间(如果落盘就浪费了磁盘空间) 所以我们将dtpre的部分移至topic中存储 落盘逻辑 对于落盘逻辑来说,不只是dtpre的逻辑需要修改,如此对于一般的消息来说,都应该进行落盘 而channel来说只需要落盘数据索引即可 修改细节 实际这次提交修改了比较多的内容,最核心的还是移除了memoryMsgChan(无论是 topic 还是 channel),添加了backendMsgChan. 读写轮盘在于 1. nsqd/diskqueue_reader.go 采用了定时器pull方式,而不是之前的push方式 这个地方可能存在性能问题,因为每次是拉去tryReadOne的方式 2. nsqd/diskqueue_writer.go 里面writeOne函数,其实没有写入磁盘,而是写入了一个buffer(注意对于roc

By chainhelen

消息队列

go-nsq bug

起因 公司同事发现,其topic数据均摊在k8s里面 5个 nsqd 但是其中两个nsqd对应的消费channel已经出现积压,甚至落盘过万条数据 触发条件 注意每个 consumer 与 每个 NSQD 都有连接(图中没有画出) 每个consumer的maxinflight设置都是1 使用最新的官方sdk版本go-nsq v1.0.7 参数解释 这里面有两个参数需要解释一下,但是是从consumer的角度解释的,同样的参数在nsqd中可能含义不一样 RDY是代表当前消费者还可以接受多少条消息,进行处理(在上面场景,大部分情况都是0、1) maxinflight代表是当前还未完全处理完的消息最大条数(默认是1条) 负载均衡 例如从consumer A角度来看,有这样的场景,len(A.conns) > maxinflight 也就是说,consumer A在同一时间内,不能够RDY多个nsqd,所以只能暂时选取其中一个,然后过一段时间再来处理其他的nsqd上面的消息,实际在consumer里面确实有一个定时器去做这件事 fun

By chainhelen

lock

分布式锁

起因 之前遇到一些场景,使用了分布式锁,目前来做一个总结 redis 1. 单点redis 单点redis场景,主要容易存在单点故障。(分布式高可用的手段:1.单点故障转移 2.数据冗余) // 获取锁 SET key value NX PX xmilliseconds // 删除锁 if redis.call("get", KEYS[1]) == ARGS[1] then return redis.call("del", KEYS[1]) else return 0 end 设置key值,需要设置一下随机value,避免锁被其他竞争者删除 设置过期时间,避免客户端崩溃之后,

By chainhelen

势

起因 今年之前我写过一次总结,关于流程规范的,而且里面提到执行最佳手段,然而短短不到半年我又需要去推翻先前的理论。(或者严格地说并不是推翻,而是做一次递进。)总体上来说,触发我这次思维跃迁的主要是某位产品运营刘的离职,让我再一次确认一个道理 —— 职场如战场。 孙子曰:兵者,国之大事也,死生之地,存亡之道,不可不察也 手段 关于我当时认为的深不可测(我认为越聪明的打工者越能感觉到恐惧感),然而这种恐惧感也是一种有效的方式。也就是说 越聪明的打工者你以为你凭借自己聪明察觉到的细致形势,也不过是管理者故意透露给你的。如果你从聪明的打工者角度出发,你会感受到安全感,这种安全感是你自己带来的。另一方面,卖破绽并不是一直有效的,如果你需要走得越高,你需要更多人的支持,所谓以人为本。情绪化表达带来的后遗症也比较多,控制性的主动权在你这,但是容易失误。也就是需要更高明的手段,但是首先第一点,得学会忍。更高明的手段,需要把情绪表达地更细微,甚至是仅仅是一个眼神。 谋势 当一些事情你推不动的时候,或者别人并不听从你的一些任务的时候,你需要谋势。 (当然,所有事情都是要建

By chainhelen

内存

虚拟内存地址计算物理内存地址

产生的困惑 mq落盘的时候,rocketmq采用mmap,但是多处mmap同一个文件,会不会导致映射多次到物理内存上? 页是内存管理的最小单位(通常是4k) 查看程序虚拟地址 利用 man proc 可以看到命令介绍,/proc/[pid]/maps里面关于一些参数解释 /proc/[pid]/maps A file containing the currently mapped memory regions and their access permissions. See mmap(2) for some further information about memory mappings. Permission to access this file is governed by a ptrace

By chainhelen