go

golang

golang 神坑range

总结一下碰到的一些range问题,尤其是边loop边delete的骚操作,我一直以为是人家开源库的bug,直到我看到golang官方也这么用。 首先是比较经典的问题,我们团队之前确实有人写这样代码出事了。 v是数据复制 1. 代码本意是为了获取每个slice每个元素的指针,构造成新的slice type P struct { Name string Age int } func main() { o := []P{ P{"chain1", 20}, P{"chain2", 21}, P{"chain3", 22}, } oPointer := make([]*P, 0, 3) for _, v := range o { oPointer = append(oPointer, &v)
By chainhelen

go

golang 非协作式抢占

最近因为dlv里面有个bug,关于go1.14版本之后非协作式抢占扩大了调试状态下的一些协程问题。 于是就找了原始的提议看了看,恩,果然大部分都看不懂!!! 利用google/baidu式的翻译,手敲了一遍,并且存疑的地方都加了一点东西,算是给自己一点做个笔录吧,后面有理解更深的地方会更新一下自己的理解。 翻译笔录英文版本如链接 摘要 go 当前在编译器插入的函数序章中插入协作抢占点。在大多数情况下,这足以让golang开发人员忽略抢占细节,专注于编码清晰的并行代码,但是这种方式有着非常尖锐的问题,以至于我们一次又一次的看到它降低了开发人员的体验。当它出现错误时候,就会呈现出惊人的错误现象,导致未知的系统层面的延迟问题,甚至有时候会完全冻结(就是卡住不动的意思)。因为这个是存在于golang语言语义之外的语言实现问题,这些错误是非常令人吃惊的,并且非常难以调试。 @dr2chase已经投入了大量的精力在循环中建立协作抢占点的原型,这是解决这个问题的一种方法。然而,即使是复杂的方法也会导致在紧密循环(我理解就是死循环或者短时间无法跳出的循环)中无法接受的减速(这种

By chainhelen

go

调试器与GO

调试器 如果把调试器看成一个产品的时候,首先他应该具体的功能有哪些? 1. 断点 2. 代码与当前断点映射(例如查看源码) 3. 断点过后继续运行(继续执行,单步,单出) 4. 打印变量 附属的功能: 1. 打印调用栈 2. 打印堆栈 3. 函数调用 4. 条件断点 5. 反汇编 ... 调试状态 linux会有trace进程的状态,对被trace的进程可以进行控制 基本功能 断点 断点通常分为两种,硬件断点和软件断点 1. 先说硬件断点,这个我们(普通的后台开发)平时不太常用,对于x86系统来说, 是依赖寄存器DR0~DR7和2个MSR实现的 说直白一点,就是可以把内存地址放到寄存器内,当cpu进行 读、写、修改该地方内存时,就会触发trap 2. 而对于软件断点,

By chainhelen

go

godbg 介绍

Start a new project, the debugger on linux platform for go. This project is inspired by dlv github地址 背景 没想到这个项目最终还是沦为为一个玩具。初次有这个想法是因为发现 gdb调试golang代码是可以进入runtime的指令,而dlv却不可以。例如像map这种的初始化 s := make(map[int]string, 20) 主要是dlv将runtime的代码都skip掉了,表示对golanger无需关心底层的逻辑,只需要关心自己编写的代码即可。 先看一下效果 实现 代码本身分为5个步骤,代码是在main.go 1. 获取生成含.debug可执行文件的路径 2. 编译创建可执行文件 3. 分析可执行文件里面的_zdebug的字段,以便后续调试使用 4. 执行可执行文件,并且ptrace

By chainhelen

go

go源码阅读 slice

slice 对于slice来说,其实源码部分并不多,主要看一下make slice、growslice、slicecopy和copy 编译阶段 make slice语句跟map一样,在compile的typecheck阶段,将MAKE节点偷偷换成OMAKESLICE节点 关于oppend的代码实在/usr/local/go/src/cmd/compile/internal/gc/ssa.go的func (s *state) append(n *Node, inplace bool) ,这个是编译时代码 关于slice的代码在/usr/local/go/src/runtime/slice.go ,这部分是运行时代码 type slice struct type slice struct { array unsafe.Pointer len

By chainhelen

go

go源码阅读 defer

defer 这个话题有点大,只是翻阅了关键代码,细节太多了 主要defer要弄明白两个函数,函数目录在/usr/local/go/src/runtime/panic.go中的deferproc和deferreturn deferproc //主要这里面都不能使用栈分裂,不能进行逃逸分析,因为defer是希望利用栈内存处理 //go:nosplit func deferproc(siz int32, fn *funcval) { ... d := newdefer(siz) // 最核心的就是这里 ... } // 核心新建defer的逻辑 func newdefer(siz int32) *_defer { //获取当前协程 gp := getg()  ... // 这中间主要优化defer内存逻辑,看能不能复用 // 如果d==nil,说明上面没有获取有效大小,需要创建 if d == nil { // 分配defer和其args的内存 systemstack(func(

By chainhelen
go源码阅读 map

go

go源码阅读 map

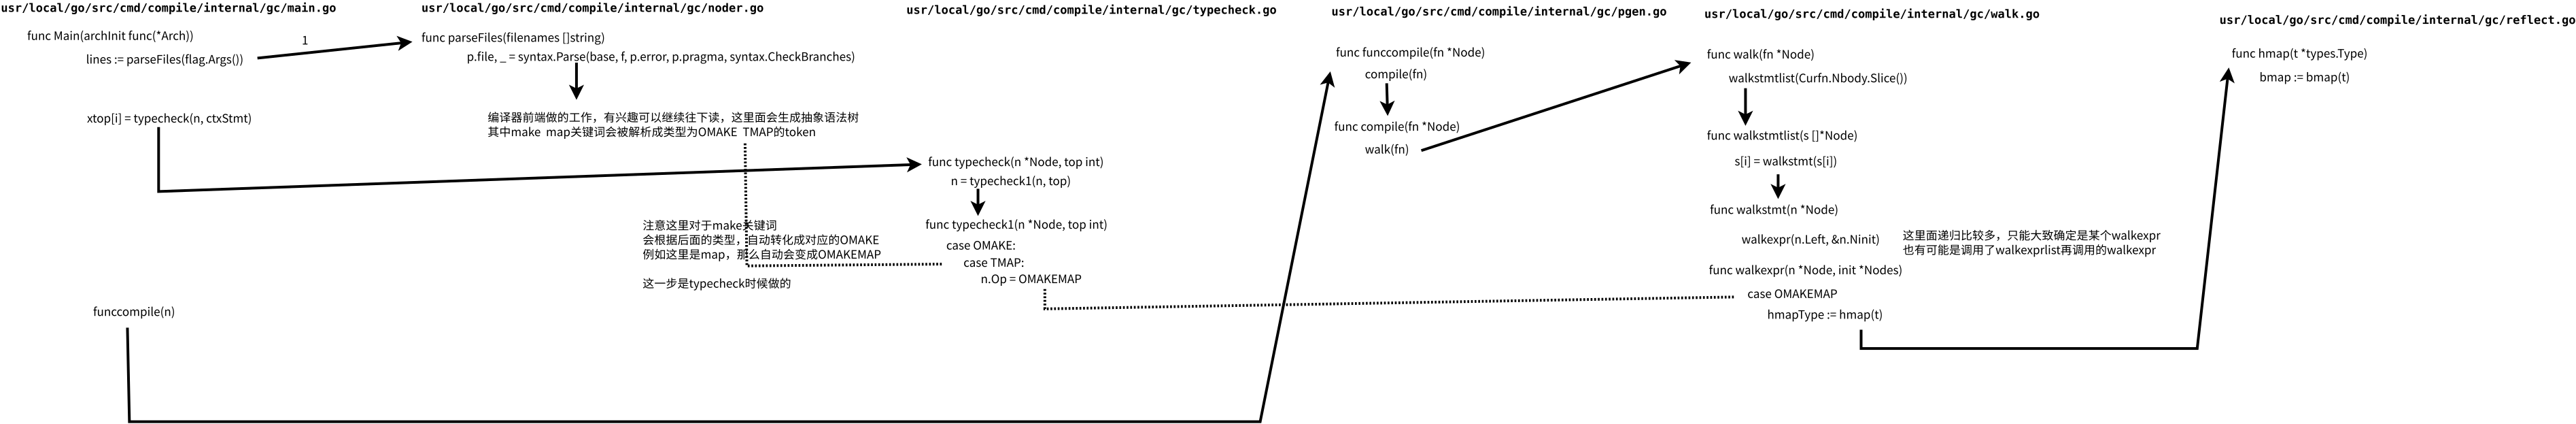
序 关于map的实现,我按照我的思路来看源码,中间尝试了挺多的case,最终选了一些来作为实例 可能跟网上其他人不太一样  准备工作 首先做一些准备工作,跳过一下与编译无关的过程,例如搜索依赖关系    1. 样例代码 新建临时目录test_map,在该目录下写入样例代码 // main.go package main import ( "fmt" ) func test_map() { s := make(map[string]int, 3) s["chainhelen1"] = 1000 s["chainhelen2"] = 2000 s["chainhelen3"] = 3000 fmt.Printf("

By chainhelen

go

nsq 支持分布式事务(三)

主备同步 代码提交记录 完成度 只完成了主从复制;但是主备切换、依据处理能力动态调整消费能力、一些write失败逻辑处理 没有完成 基本逻辑 数据 主要分成了三部分数据的复制 1. 发送SLAVE_SYNC_INFO命令,返回所有的topic和其对应的channel 2. 发送SLAVE topic_name命令,携带当前topic的关键4个参数fileindex filenum totalMsgCnt viroffset和一个maxnum希望本次同步返回的消息数量,返回 master的关键参数和消息本身 3. 发送SLAVE topic_name channel_name,携带当前的4个关键参数,返回master的关键参数 客户端请求 对于slave是不可以接受普通client的请求的 ,连接master复用了master与client的 tcp端口 同步 or 异步 一开始写了一个同步版本,就是slave每次发送SLAVE消息,就等待结果 后来改成了异步发送,异步里面主要需要做大量的check避免时序问题,造成SYNC数据错乱问题

By chainhelen

nsq

nsq 支持分布式事务(二)

核心代码逻辑 commit 修改dtpre队列 在考虑落盘之前,先思考另一个问题,由于dtpre本身跟消费者无关,只跟生产者有关,其实并不需要等到消息从topic分发到各个channel里之后再进行commit(cacel),浪费存储空间(如果落盘就浪费了磁盘空间) 所以我们将dtpre的部分移至topic中存储 落盘逻辑 对于落盘逻辑来说,不只是dtpre的逻辑需要修改,如此对于一般的消息来说,都应该进行落盘 而channel来说只需要落盘数据索引即可 修改细节 实际这次提交修改了比较多的内容,最核心的还是移除了memoryMsgChan(无论是 topic 还是 channel),添加了backendMsgChan. 读写轮盘在于 1. nsqd/diskqueue_reader.go 采用了定时器pull方式,而不是之前的push方式 这个地方可能存在性能问题,因为每次是拉去tryReadOne的方式 2. nsqd/diskqueue_writer.go 里面writeOne函数,其实没有写入磁盘,而是写入了一个buffer(注意对于roc

By chainhelen