Apple 文章译解:Transformer 怎样才能更适合 ANE?
从四维布局、1×1 卷积、多头注意力到权重复用,用四张图理解 Apple 2022 年的 ANE 优化思路。
原文是 Deploying Transformers on the Apple Neural Engine,发布于 2022 年 6 月 6 日。隐含一个问题,为什么同一套 Transformer 权重换一种写法,就可能更需要一块独立芯片?
沿着输入进入模型的过程,可以分成四个相互承接的问题:
- 输入怎么存,才不会浪费空间?先看 ANE 缓冲区的对齐要求,解释为什么把 token 轴放在四维张量的最后,避免在长度为 1 的轴后填入大量空位。
- 布局换了,原来的线性层怎么接着算?特征轴移到通道位置后,用 1×1 卷积完成原来的线性投影,让 Q、K、V 直接按新的布局产生。
- 有了 Q、K、V,注意力怎样沿用这套布局?把各个头的计算拆开,并直接指定沿哪个轴求和,减少为了凑乘法形状而做的中间变换。
- 这些开销降下来后,什么还可能限制速度?最后检查权重读取:短输入让同一份权重服务的 token 太少,计算变快后,等待数据仍可能占去大部分时间。
Apple 报告其优化后的 DistilBERT 示例,相比基线实现,速度最高约为 10 倍,峰值内存最低约为基线的 1/14。这是原文特定模型、设备和测量条件下各项指标的结果,不是所有 Transformer 的保证,也不是 Kapitsa 的测试。详见 原文图表与测试说明。
1. 输入布局:为什么是 [B,C,1,S],而不是随便补一维?
为了看清维度,假设输入只有“我、爱、猫”三个 token,每个 token 用两个数表示。这里是手工构造的教学输入;真实 tokenizer 不一定逐字切分,实际向量也不是图里的 0 和 1。
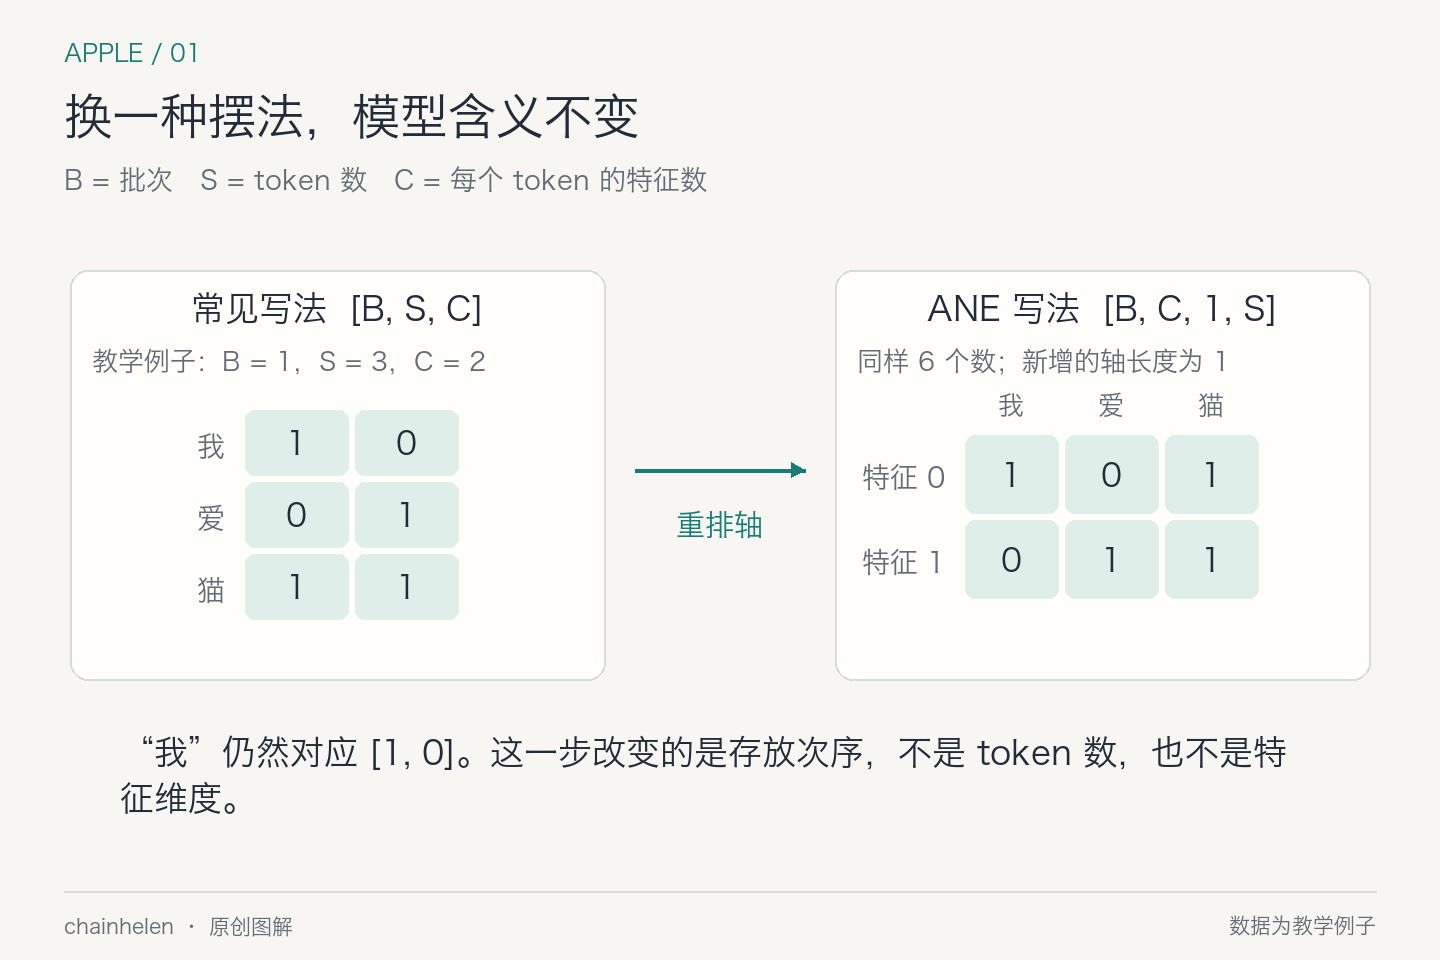
常见表示 [B,S,C] 可以读成“B 句话,每句话 S 个 token,每个 token 有 C 个特征”。参考实现使用 [B,C,1,S]:特征轴提前,token 轴放到最后,中间增加一个长度为 1 的轴。
四维、通道在前 是 Apple 为文中 ANE 硬件与软件栈选择的算子布局;把 S 放在最后,则有具体的内存原因。按 原文对缓冲区的说明,最后一维需要连续存放,并按 64 字节对齐。若把长度为 1 的轴放在最后,一个 FP16 数只有 2 字节,这一小段仍要占到 64 字节。
只看这条对齐规则,另设一个 B=1、C=2、S=32 的算例:两种布局都装 64 个 FP16 数,但留空的位置完全不同。
[1, 2, 32, 1]:64 段,每段只有 1 个数
                  2 字节补到 64 字节 → 4096 字节

[1, 2, 1, 32]: 2 段,每段连续放 32 个数
64 字节,无须在段末补齐 → 128 字节这是根据最后一维对齐规则做的教学计算,不是整个模型的内存实测;其他轴怎样存放仍由编译器决定。它说明:补一个维度本身没有收益,轴放错位置反而可能让大部分空间用来填空。这里引用的是 2022 年原文的约束,也不意味着所有后端都应统一改成这个布局。
布局确定后,紧接着要处理的是作用在特征轴上的线性层。在常见的 [B,S,C] 写法里,Linear 可以直接处理末尾的 C 个特征;换成 [B,C,1,S] 后,最后一个轴已经是 token 位置 S,不能原样照搬这一步。Apple 因而连同算子一起改写。
2. 线性投影:用 1×1 卷积配合新的布局
Attention 首先对输入做三次线性投影,分别得到 Q、K、V。每次投影都是:取出一个 token 的特征向量,乘上这一分支的权重;其他 token 也使用同一套权重。此时还没有在不同 token 之间汇总信息。
1×1 卷积恰好能在 [B,C,1,S] 的每个位置,读取 C 个通道并做这样的加权求和。卷积核只覆盖一个位置,不会把相邻 token 一起卷进来。因此,参考实现的 Q、K、V 投影 可以写成 Conv2d(..., 1),继续表达原来的线性变换。
把其中一次投影缩小来看:假设一个 token 的输入是 x=[1,2],三个输出分别取第一个数、第二个数和两者之和,结果就是 [1,2,3]。下面的图把 Linear 与 1×1 卷积对应到同一组乘加。

对应关系是:Linear 权重的形状为 [输出特征, 输入特征],1×1 Conv 权重则是 [输出特征, 输入特征, 1, 1]。后面两个 1 不添加新的可学习数值。参考实现的 linear_to_conv2d_map 正是给二维权重加上两个长度为 1 的轴,以装载原来的参数。
图中的 2→3 是这组权重规定的输入、输出特征数;线性投影也可以保持维度不变。把 Linear 换成 1×1 Conv,本身不会额外增加特征,也不需要重新训练一套权重。到这里,我们已经知道输入怎样生成 Q、K、V,接下来才是它们之间的注意力计算。
3. 多头注意力:把计算拆小,减少中间数据搬运
Q 用来发出查询,K 用来与查询匹配,V 保存匹配后要汇总的内容。多头注意力会把三者的特征分成若干组,每组各算一份注意力:Q 与 K 得到匹配分数,softmax 把分数变成比例,再按比例汇总 V。
这里要分清模型结构和实现方式:多头本来就是模型的一部分;Apple 改的是把各个头的计算显式拆开。每次处理的中间张量更小,更有机会留在靠近计算单元的缓存里。下面先画清楚“拆头”到底拆的是哪一部分。
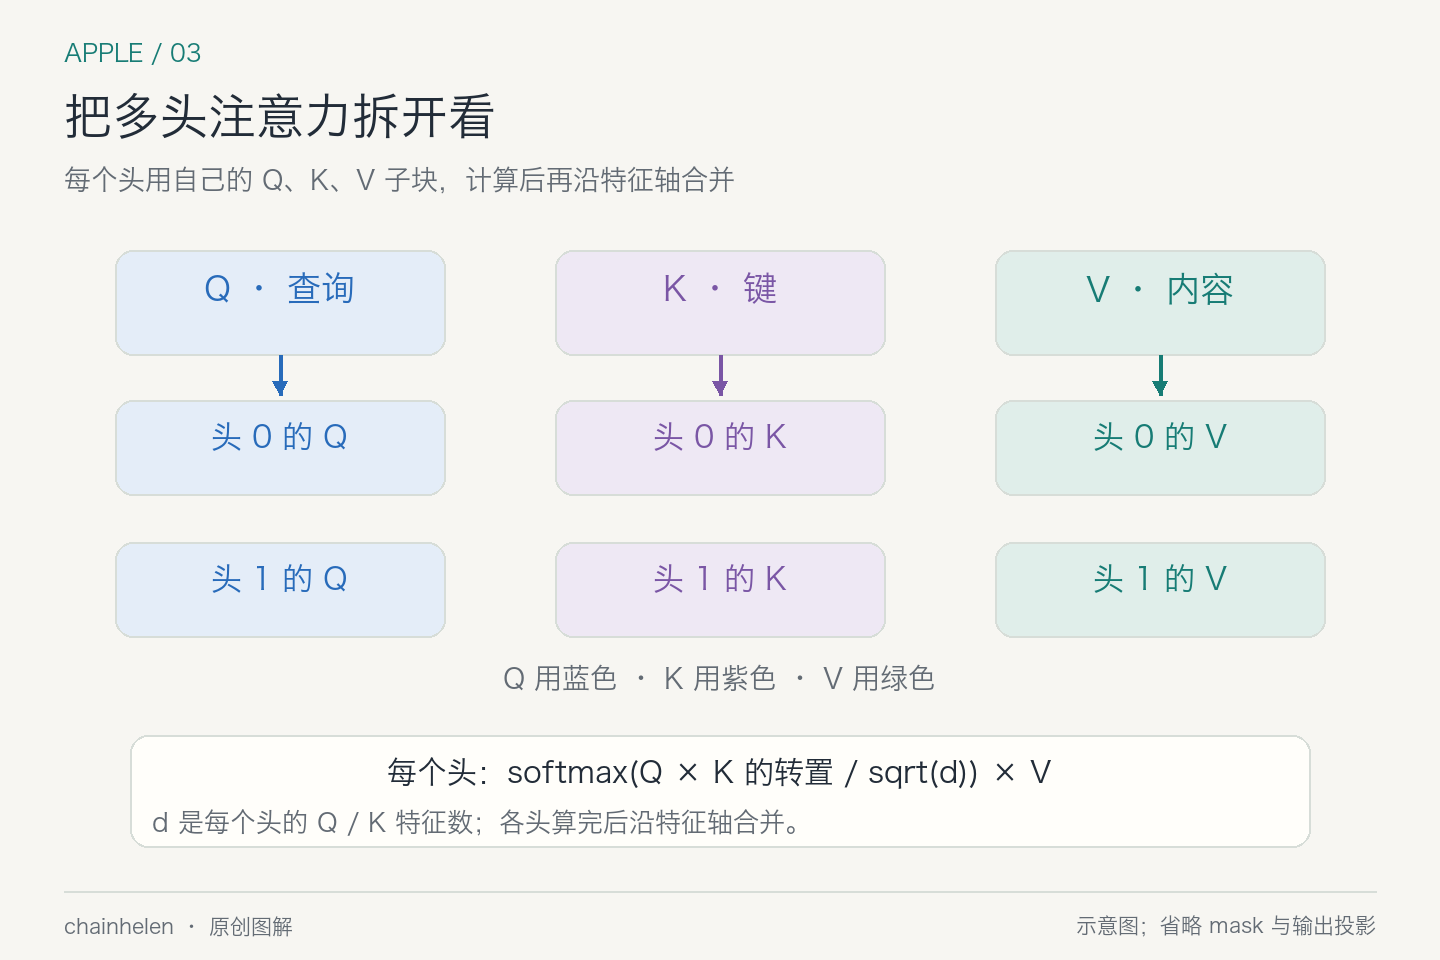
比如每个 token 的 Q、K、V 各有 8 个特征,分成 2 个头后,每个头拿到各自的 4 个特征。两个头仍然都处理这句话的全部 token,并不是一个头负责前半句,另一个头负责后半句。各头完成汇总后,再把结果合回特征轴。
具体怎样省掉变形?让乘法接受已有的轴顺序
常见的多头实现会先拆出 head 轴,再交换轴,把张量整理成批量矩阵乘法需要的形状,算完再换回去。数学上需要的是“哪些数相乘、沿哪个轴求和”,并不要求只能按这一串变形来表达。
在本文固定版本的 核心注意力函数 _attention_fn 中,具体处理如下。设 c 是单个头的特征数,q、k 分别表示查询位置和被查询位置:
- 沿特征轴切分 Q、V,各头仍保持四维形状:Q 为
[B,c,1,q],V 为[B,c,1,k]。head 由外层列表表示,不另加一个张量轴。 - K 先做一次
transpose(1,3),再切分,得到各头的[B,k,1,c]。这里并没有声称把全部转置消掉。 - 用 einsum 指定:沿特征 c 配对求和,直接输出
[B,k,1,q]的分数;随后沿 k 做 softmax。 - 再沿 k 对 V 加权求和,直接得到
[B,c,1,q];最后沿特征轴拼回各头。
例如第三步的求和关系可以写成:
score[b,k,0,q] = Σc Q[b,c,0,q] × K转置后[b,k,0,c]先把下标放在一边:这一步仍然是把两个 token 的特征逐项相乘,再加起来。例如 Q=[1,2]、K=[3,4],分数就是 1×3+2×4=11。einsum("bchq,bkhc->bkhq", ...) 告诉计算框架“从哪些位置取数、沿特征轴 c 求和、按什么轴顺序输出”。其中 h 是长度为 1 的轴,不是 head 数。
下面只比较一件事:为调整布局,是否需要把同一份数据完整复制一遍。

在图示条件下,省掉一次 1 GB 的重排副本,就少了 1 GB 读取和 1 GB 写入,合计减少 2 GB 的额外搬运。计算本身所需的读写不变。
这是教学假设,不是 ANE 实测:transpose 可能无需复制,einsum 也不保证消除复制;实际收益以编译结果和实测为准。
这些办法别的处理器也能用,为什么还需要 ANE?
减少复制确实是通用优化,CPU、GPU 实现也可以做。这里仍然要执行投影和注意力中的乘加运算;ANE 是承接这些计算的专用硬件。布局改写解决的是“交给它算时,能否少浪费存储和搬运”,两者共同影响耗时与能耗。
4. 优化之后的限制:短序列仍可能主要耗在读权重
到这里,布局与注意力计算的改写已经讲完。接下来是性能边界:少了中间数据的复制,模型本身的大份权重还是要读取。输入很短时,一份权重从内存读过来,只为少数几个 token 做完计算,就要换下一份权重;于是乘加部分即使已经很快,完整推理仍可能主要在等数据。
这不是与前面并列的另一种布局技巧,而是判断优化效果时必须再检查的瓶颈。下面用同一份 W 被多少行输入使用,解释“读取一次权重,能做多少有效计算”。
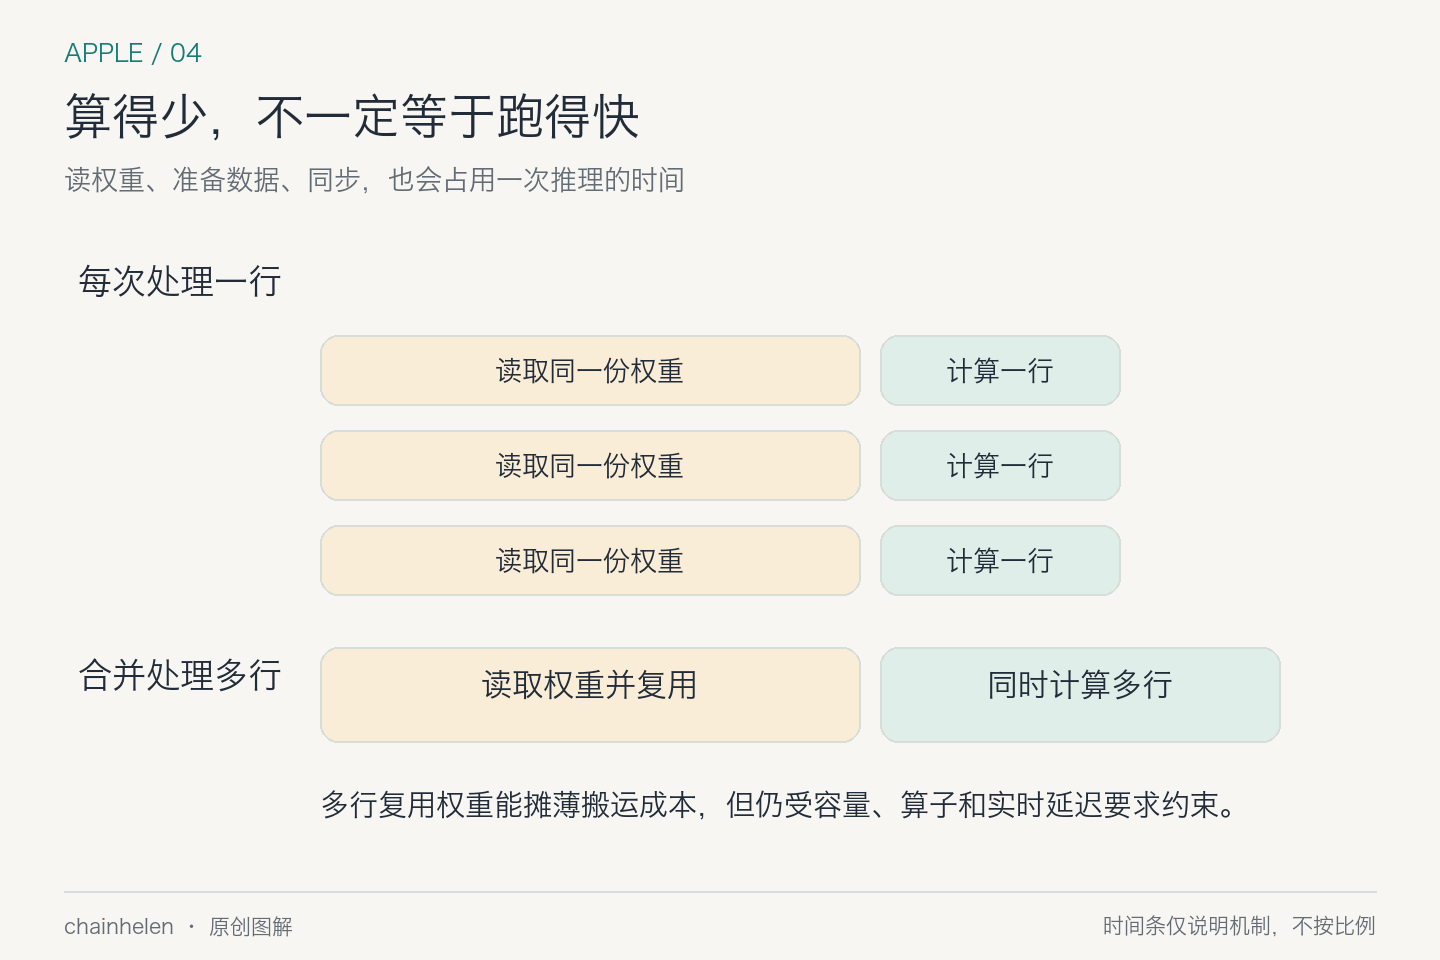
从矩阵乘法看,同一份 W 若能被 T 行输入复用,就有机会把读取权重的成本分摊到更多 token 上。这也解释了一个反直觉现象:输入变短,乘加次数少了,读取权重的工作却未必同比例减少,所以耗时不一定跟着成比例下降。
这里的 W 是投影层已经训练好的参数;上一节的 Q、K、V 则是本次输入算出来的数据。前者要从模型参数中读取,后者会随输入改变。把这两类数据分清,才能看懂“减少中间张量”和“提高权重复用”分别在优化哪一段开销。
因此,能否把多份输入一起处理、权重能否用更紧凑的表示存储,都值得在具体任务中测量。但批量增大也会占用更多内存,并可能增加等待时间,不能只按吞吐量作判断。
回到主线
同一套权重换一种写法,之所以可能更快,是因为数学上相同的计算,在硬件上可能付出不同的存储和搬运成本。按前面的四个问题,结论分别是:
- 输入布局:关键在于轴顺序与对齐规则是否匹配。文中的 [B,C,1,S] 把连续空间留给 token,避免把大量空间花在补齐长度为 1 的轴上。
- 线性投影:布局改变后,1×1 Conv 让算子继续在特征轴上使用原来的权重,保持每个 token 的投影含义。
- 注意力计算:沿用四维布局,按头计算点积与加权求和,减少额外的中间变形;模型仍然在做多头注意力。
- 性能边界:减少这些开销之后,仍要读取模型参数。若短序列下读取权重成为主要耗时,就要另看批量复用或参数压缩的收益与代价。
本文配合阅读的参考代码固定为 apple-aiml-research/ml-ane-transformers @ 590eb35。原文是 2022 年资料,这份代码阅读快照用于定位实现,不代表这里验证过今天所有系统版本的部署兼容性。

