Kapitsa 源码拆解 04:GPU 与 ANE 如何同步、并行与回滚?
沿 ready/done、两半 wavefront 和失败重跑,理解“同时工作”背后的依赖关系。
Kapitsa 用 ready / done 事件约束 GPU 与 ANE 的读写顺序,用 wavefront 调度重叠两组 token 的计算。ANE 失败时,恢复检查点并由 GPU 重算整个 chunk。本文对应这三条代码路径。
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
ready / done 约束读写顺序
GPU 完成输入打包后发出 ready,ANE 等待 ready 再读取;ANE 完成计算后发出 done,GPU 等待 done 再合并结果。共享内存允许两侧访问同一块数据,事件保证读取发生在写入完成之后。
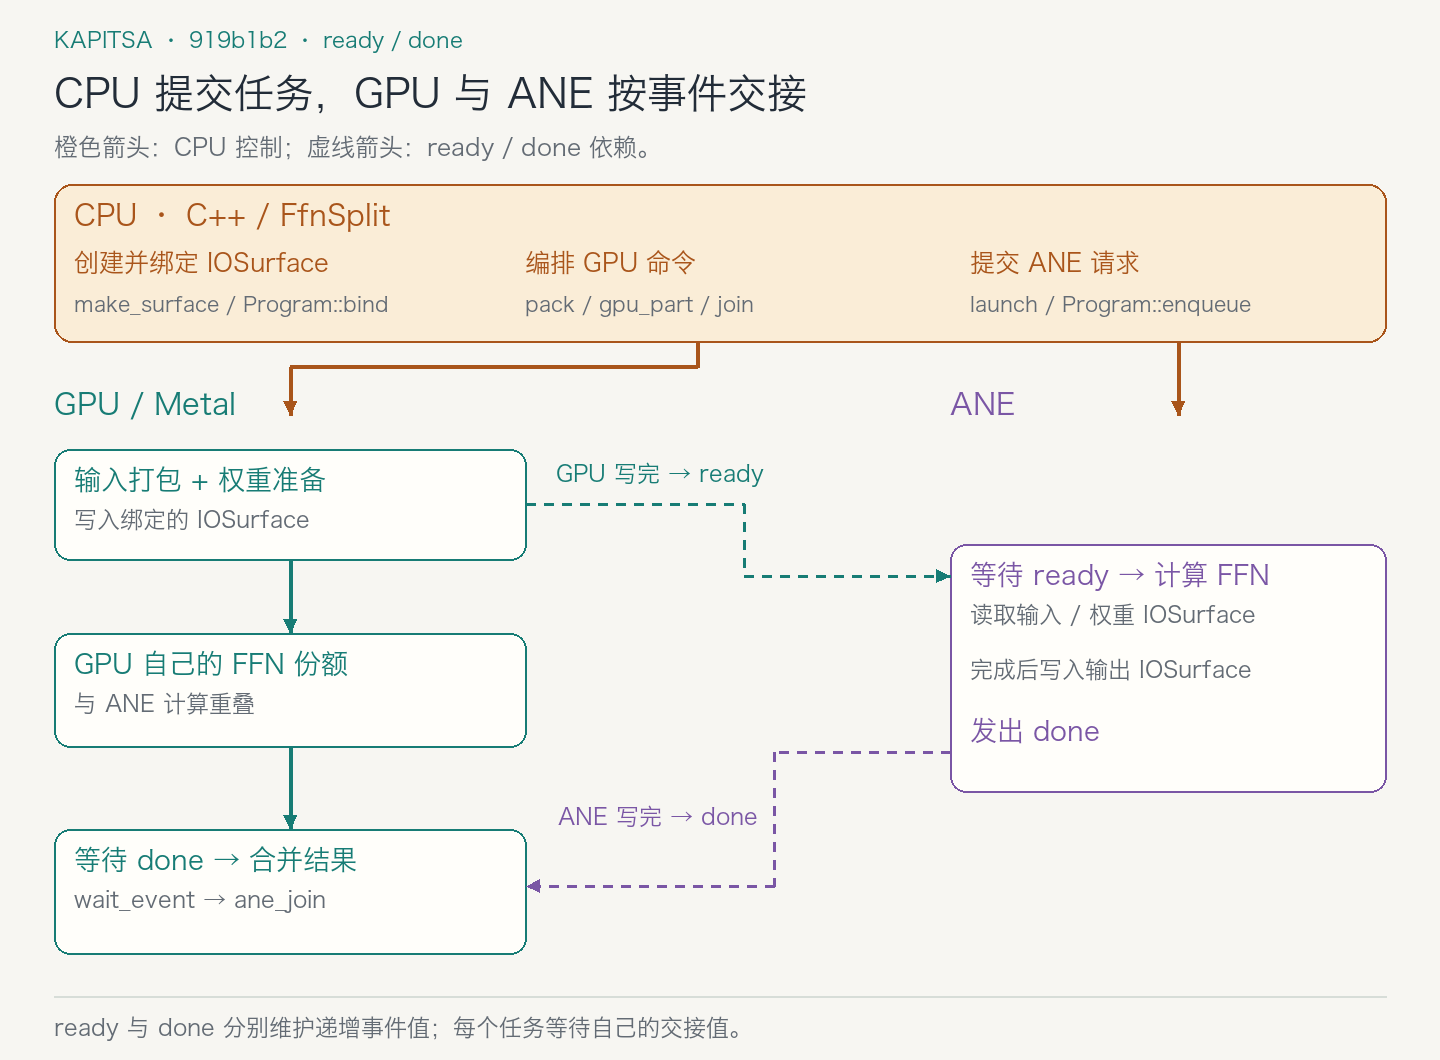
Handoff 的定义 为 GPU→ANE 的 ready 和 ANE→GPU 的 done 分别维护递增计数。每个任务使用对应的事件值,两个 token 行分组交错执行时也能区分各自的交接。
FfnSplit 的 pack 准备输入,launch 提交 ANE 任务,join 等待并合并结果,stage_layer 准备权重。CPU 通过这些接口编排 GPU 与 ANE 的工作顺序。
GPU 与 ANE 的并行执行:Wavefront 调度
普通 split 按层执行。GPU 计算 Attention 或递归 mixer 时,ANE 没有本层的 FFN 输入可用,只能空闲;进入 FFN 后,两侧才同时计算各自的通道份额。
Wavefront 将一个 prefill chunk 的 token 行分成前后两组 A、B,错开它们的层间进度。A/B 划分的是 token 行;GPU/ANE 划分的是 FFN 中间通道。两种划分同时存在。
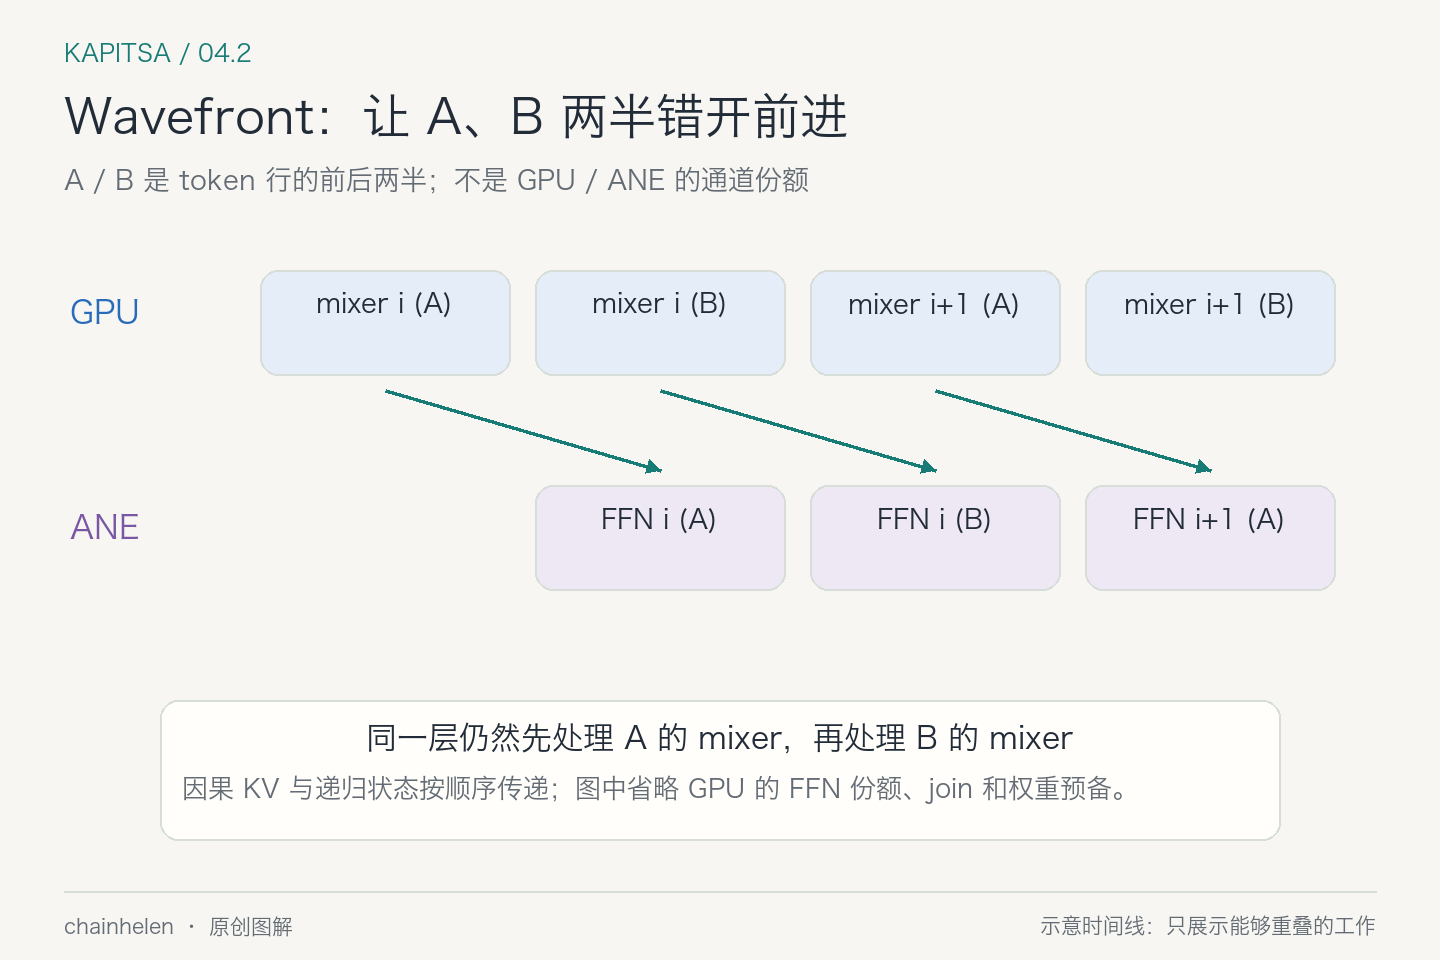
enc_prefill_wave 前的调度说明 规定:ANE 计算第 i 层 A 的 FFN 时,GPU 推进第 i 层 B 的 mixer;ANE 计算第 i 层 B 的 FFN 时,GPU 推进第 i+1 层 A 的 mixer。
同一层中,B 的 mixer 仍在 A 之后执行,以承接 A 更新的 KV 与递归状态。A、B 各有独立的激活 IOSurface;权重 IOSurface 用两组存储按层轮换。
并发收益受工作量和内存开销限制
两侧工作量不均衡时,较短的一侧仍要等待。输入旋转与打包、权重准备、事件同步和结果合并也占用时间,而且 GPU 与 ANE 共享系统内存带宽。并发能减少空闲时间,实际收益取决于这些开销。
该快照的 Qwen 路径默认尝试两组 wavefront,但 chunk 必须满足行数条件。较小的 chunk 使用普通 split 或 GPU 路径。
失败后恢复检查点并重算整个 chunk
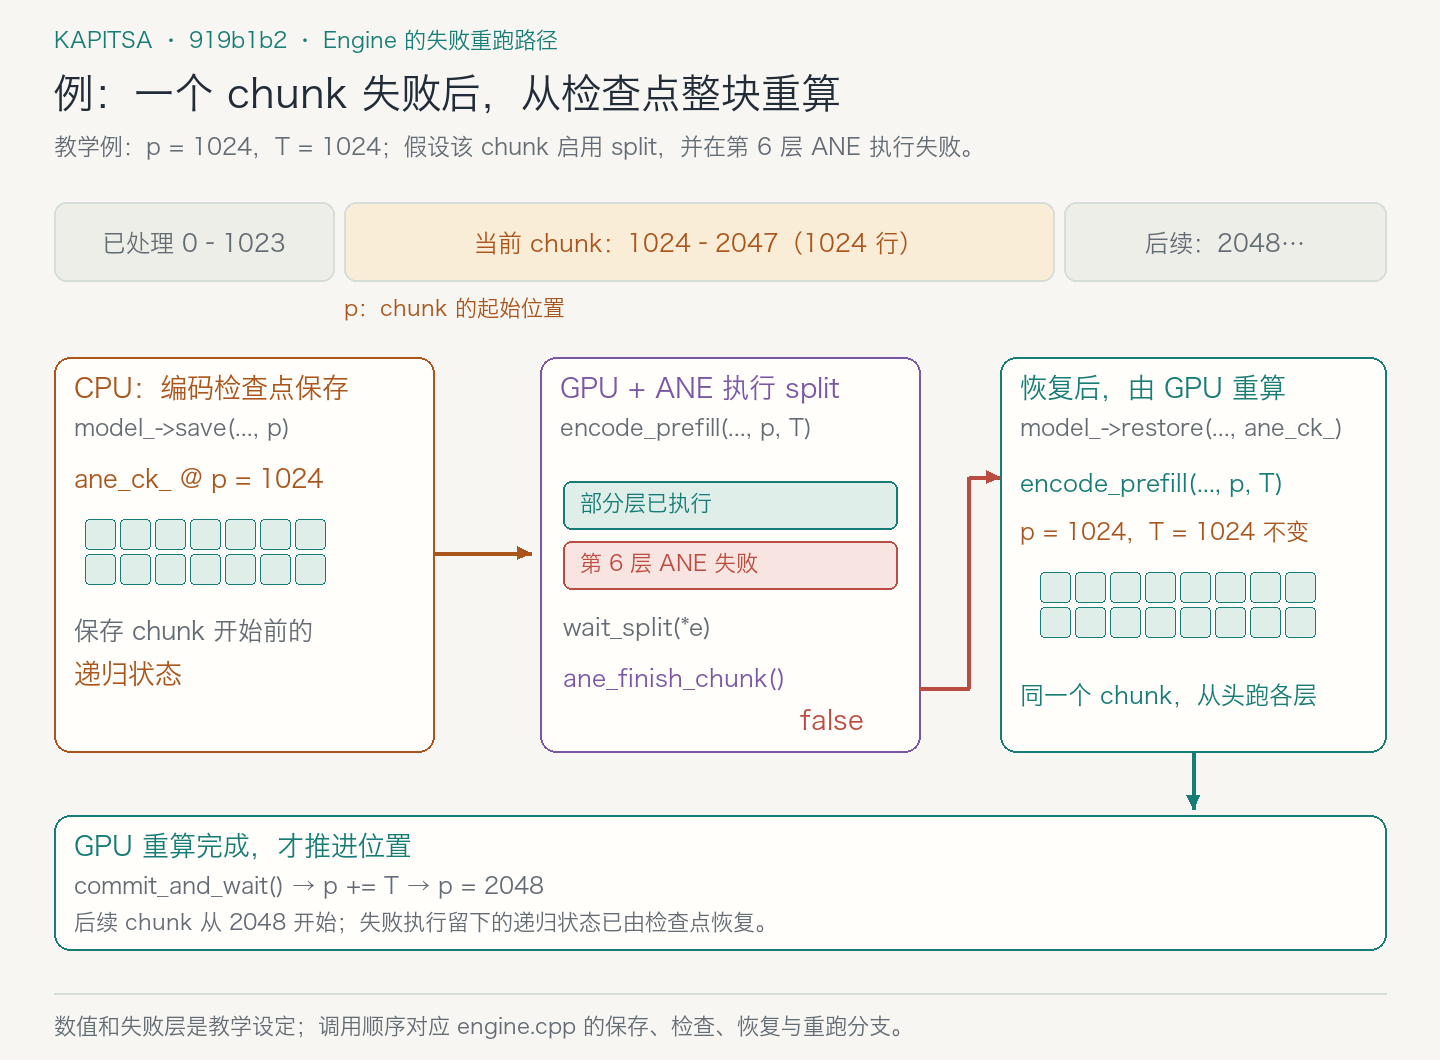
Handoff 的 watchdog 监测任务开始后的超时。ANE 无法启动、执行失败或超时时,Handoff 停用 ANE 交接,并推进事件值,解除 GPU 的等待。解除等待不代表输出有效,当前 chunk 仍需回滚。
Engine 在执行 split chunk 前保存检查点。如果 ane_finish_chunk() 失败,会恢复 chunk 开始前的状态,再调用 encode_prefill 在 GPU 上重算同一段。可以直接对照 保存、检查、恢复与重跑。
chunk 内已经执行的层可能更新了递归状态或部分缓存,因此不能只补最后一次合并。恢复检查点后重算整个 chunk,才能同时恢复计算结果和模型状态。