Kapitsa 源码拆解 03:FFN 到底怎样分给 GPU 和 ANE?
先分清 token 行、隐藏维度和 FFN 中间通道,再看分工公式、W8A8 与 IOSurface。
“GPU 和 ANE 一起跑 FFN”最容易引起的误解,是把一句话的一半交给 GPU、另一半交给 ANE。这个快照的 dense FFN split,首先切的是中间特征通道。token 行怎么排队,是另一个问题。
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
先把 FFN 的输入和中间结果命名
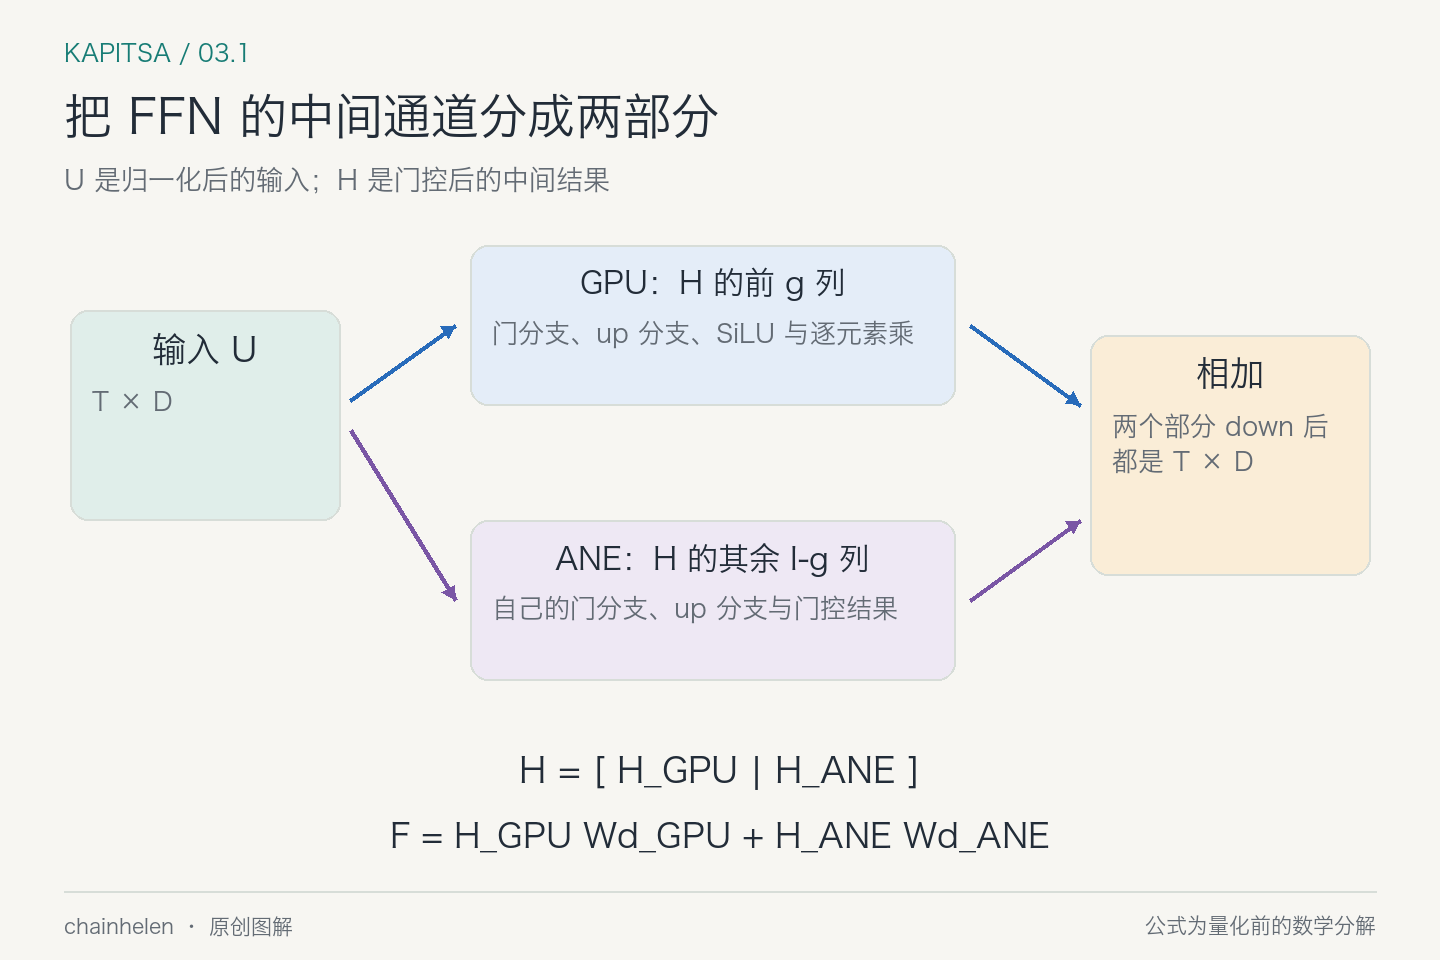
这里的 FFN(前馈网络)采用 SwiGLU 门控形式。把进入 FFN 的归一化输入叫 U,形状为 [T,D]:T 行 token,每行 D 个特征。门分支与 up 分支把它投影到 I 个中间特征,得到 G 和 P。数学上可以写成:
G:门分支的投影结果。形状 [T,I],经 SiLU 后用于调节 up 分支各个特征的贡献。
P:升维分支(up)的投影结果。形状 [T,I],保存待门控的中间特征。
H:门控后的中间特征。形状 [T,I],将 SiLU(G) 与 P 同一行、同一列的数逐元素相乘;⊙ 就是这个操作。
F:FFN 的输出。形状 [T,D],通过降维投影回到主干宽度。Wg、Wu、Wd 分别是门投影、升维投影和降维投影的权重。
这里为了便于读公式,Wg/Wu 用 [D,I]、Wd 用 [I,D] 的数学约定;实际存储方向可以不同。F 是 FFN 贡献,之后加到残差主干。它不是原始 token ID,也不是最终生成的文字。
为什么中间通道可以拆?
先忽略量化和浮点误差,把 H 沿列分成 [H_GPU | H_ANE],同时把 Wd 沿输入轴分成对应两块,那么完整结果等于两个部分结果之和。SiLU 与逐元素门控也能在各自的中间通道内独立完成。
因此 GPU 不需要再把 ANE 那些通道完整计算一次。它负责前 g 个通道,ANE 负责剩余部分,各自 down 回 D 个特征,最后相加。这就是 FfnSplit 设计说明 与 GPU 份额计算 对应的数学结构。
注意,数学上的可拆分不代表实现逐位等价。ANE 路径涉及额外量化、旋转和不同算术顺序,它是在数值误差与性能之间做工程取舍。
三个配置字段
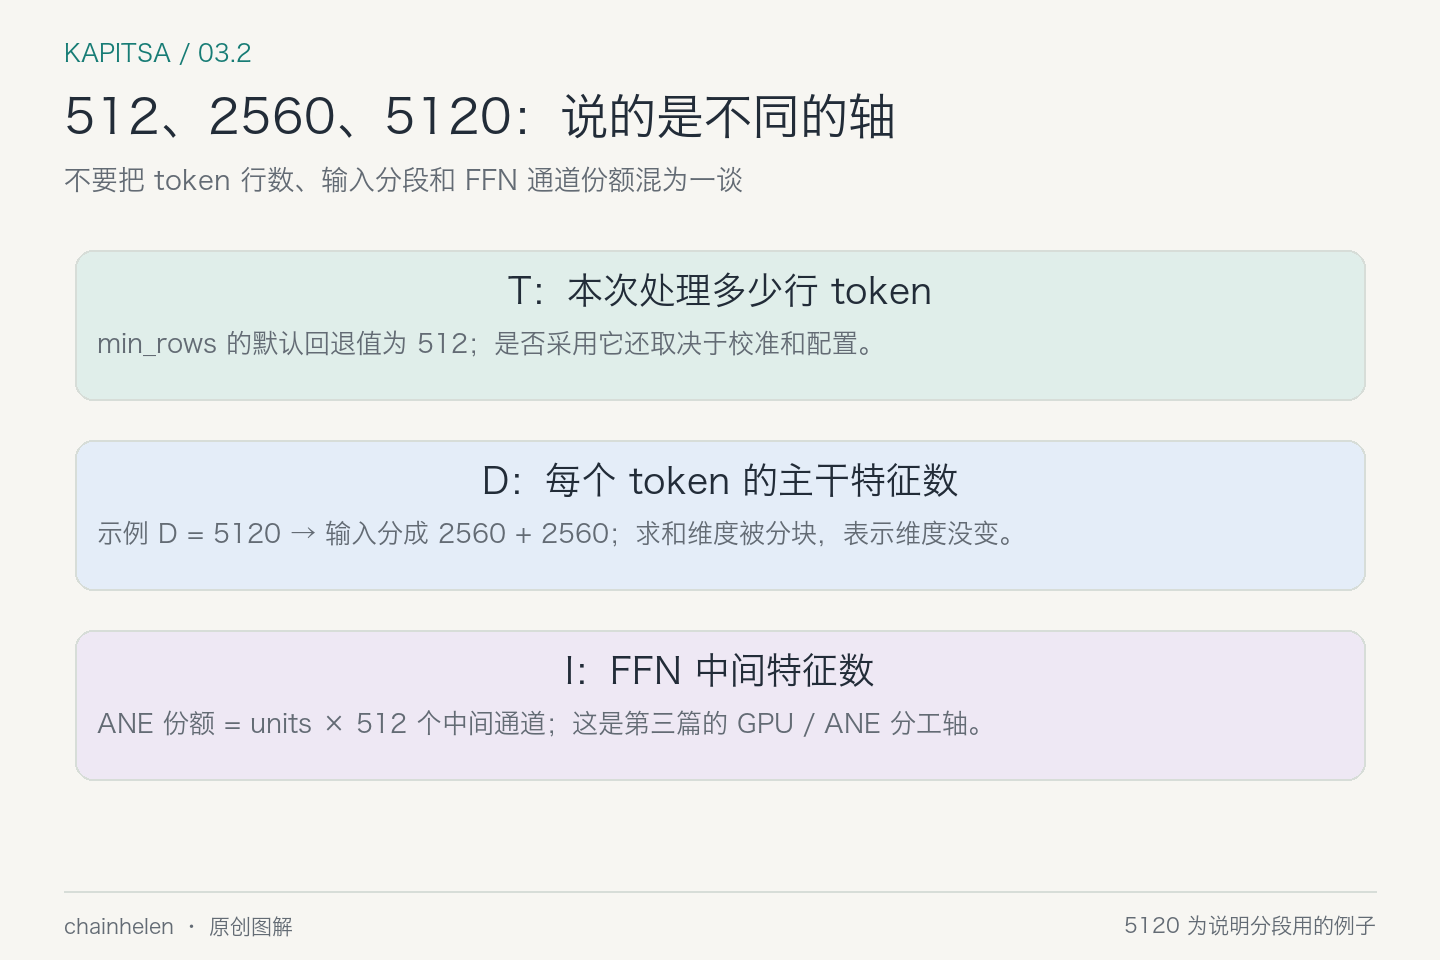
kUnit = 512:ANE 中间通道的分配单位。分给 ANE 的 FFN 中间特征按每组 512 个通道计算,例如分配 2 组就是 1024 个通道。
kSeg = 2560:输入特征的分段大小。一个 token 若有 5120 个特征,就按两段各 2560 个处理,再合并计算结果;token 数量不变。
min_rows:启用 ANE 路径的最低输入行数。每行对应一个 token。输入行数不足时走 GPU;达到门槛后,还要满足其他条件才能使用 ANE。该结构体的回退默认值为 512,实际值可能由校准或配置调整。
源码对应:FfnConfig 与常量,以及 形状检查与分段。
GPU 与 ANE 怎样交换 FFN 数据
进入 FFN 的 xh_ 是归一化后的 token 特征,按 [token, feature] 保存为 FP16。ANE 路径需要 int8、通道在前的输入,因此 GPU 先转换数值和排列,再写入共享的 IOSurface;ANE 读取它,算完后写回另一块 IOSurface。
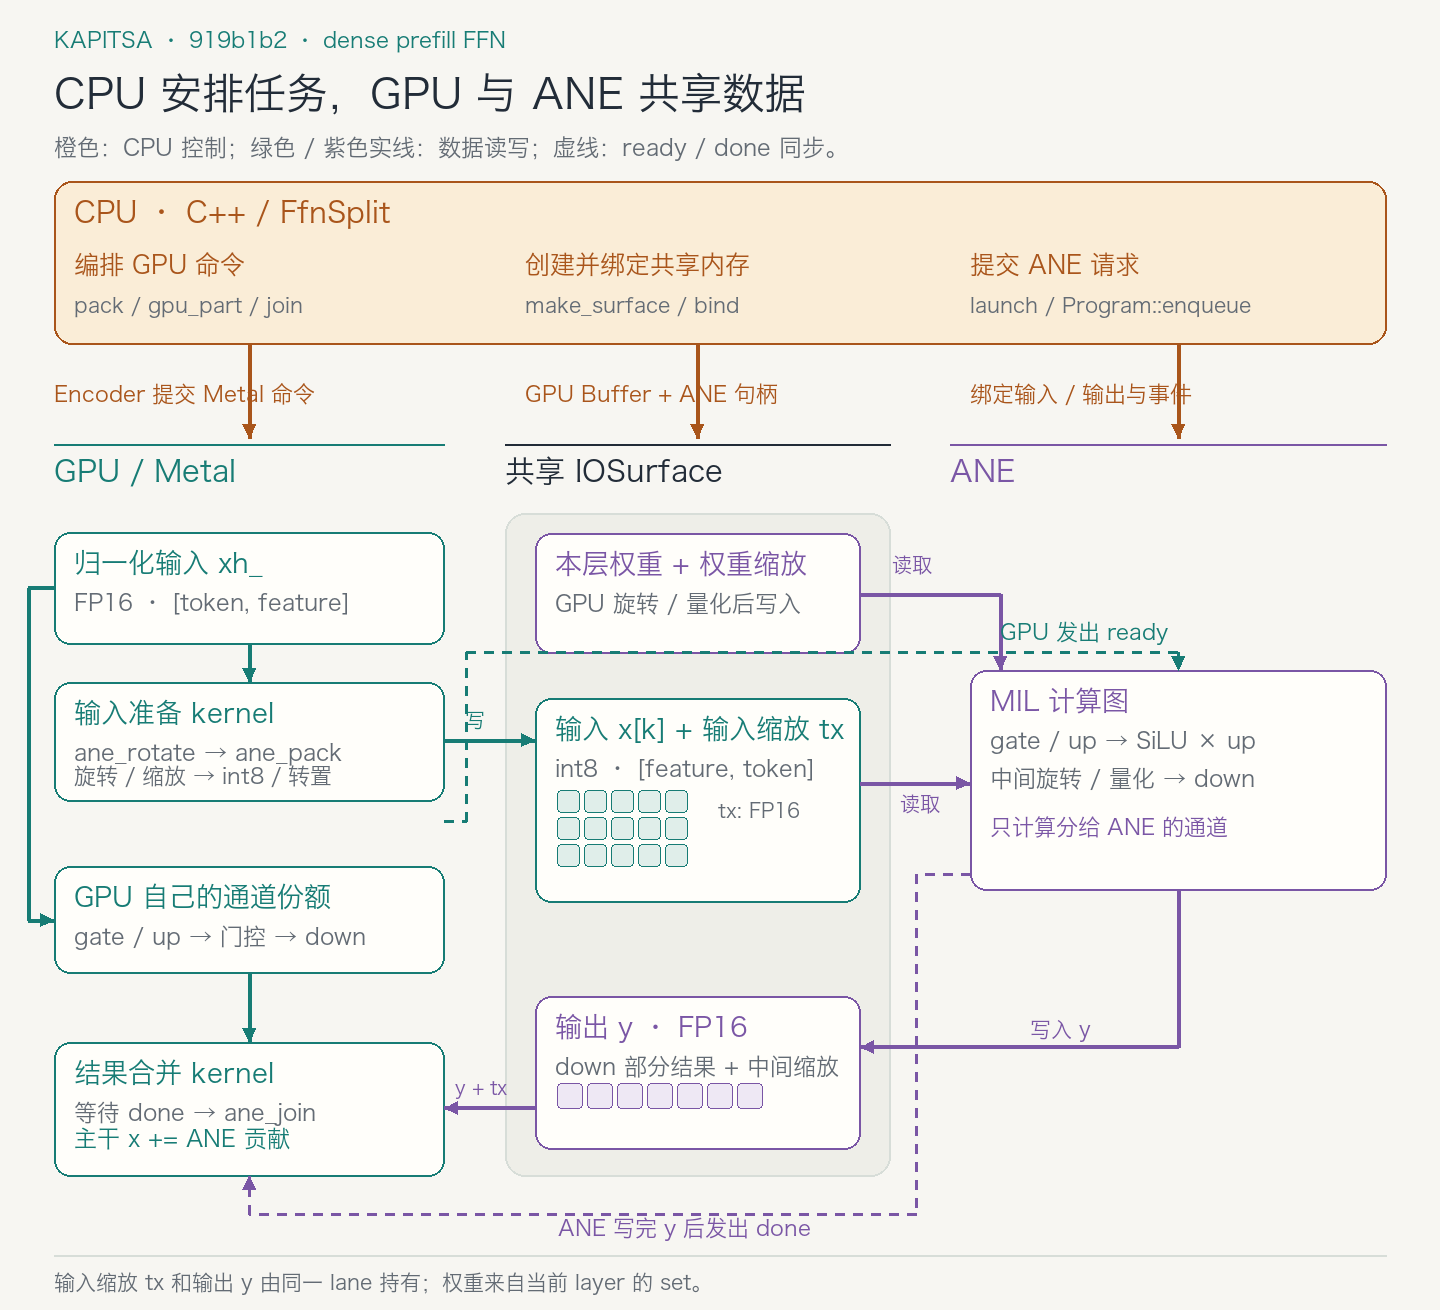
同一块 IOSurface,GPU 写,ANE 读
IOSurface 是 macOS 可供不同进程和硬件访问的共享内存对象。make_surface() 创建它,再把底层地址包装成 GPU 的 Buffer。以下摘取关键调用,省略属性定义与错误检查:
IOSurfaceRef ref = IOSurfaceCreate((__bridge CFDictionaryRef)props);
s.ref = ref;
s.buf = Gpu::get().wrap(IOSurfaceGetBaseAddress(ref), s.bytes,
                        "ane surface", /*tracked=*/true);
GPU 通过 s.buf 写入;Program::bind() 则用同一个 IOSurface 的 ref 构造 ANE 输入、输出对象。传给 ANE 的是这些对象的引用,应用代码没有先把数值逐个读回 CPU、再上传一份。
pack():旋转、量化,再调整排列
ane_rotate 对每个 token 的特征做分块 Hadamard 变换,将少数特别大的值分散到多个维度,再按该行的最大绝对值缩放,并把恢复数值大小所需的输入缩放记在 tx 中。对应权重也要做相同方向的变换:stage_layer() 把 ANE 份额的权重旋转、量化,写入权重 IOSurface。忽略量化和浮点误差时,匹配的正交变换保持点积。
随后 ane_pack 把转换后的值取整成 int8,并从 [token, feature] 转置成 [feature, token],写入输入 IOSurface x[k]。因此,“打包”在这里确实改了数值表示和内存排列,换一个指针无法完成这些工作。
launch() 与 join():用事件控制先写后读
encode_layer() 的实际调用顺序如下。权重先准备当前层,再预取下一层;本层的激活走 pack、launch、join:
if (stage && li == 0) stage_layer(e, 0, 0);
pack(e, 0, xh, T_);
if (ane) launch(e, 0, li, T_);
gpu_part(e);
if (stage && li + 1 < int(layers_.size()))
  stage_layer(e, li + 1, (li + 1) & 1);
join(e, 0, x, T_);
launch() 在 GPU 命令流中发出 ready 事件;Program::enqueue() 将等待 ready、完成后发出 done 的事件绑定到 ANE 请求。ANE 等输入和权重写好后才读取,GPU 此时可以计算自己的通道份额。
ANE 把 down 投影的部分结果与每个 token 的中间缩放写进输出 y。join() 等待 done,再调用 ane_join:用 y 中的中间缩放与 tx 恢复数值大小,并以 FP32 加回主干 x。共享内存解决“读写哪块数据”,ready / done 解决“什么时候能读写”。
这条路径的 W8A8 表示并不意味着全部运算都是 int8。MIL 计算图 还包含反量化、FP16 计算、SiLU,以及中间特征的再次旋转和量化。这里使用的是 私有 ANE 接口;权重交换区采用两组轮换,提前准备下一层,并非为所有层永久保存完整的 ANE 权重副本。
这条路径的适用边界
本篇讲的是 Qwen35 的 dense prefill FFN 路径:它检查是否为 dense 模型、行数和格式是否合适,并不把 Attention、所有 MoE 专家或 decode 一概送到 ANE。其他后端的 ANE 任务也可能不同。
启动时还会做误差检查;具体判定来自内部校验指标,不能解读成“整模型准确率最多损失某个百分比”。硬件接口、内存预算、数值误差和任务大小都可能让它退回 GPU。下一篇看它如何在可用时重叠执行、在失败时安全收场。