Kapitsa 源码拆解 06:KFlash 将候选 token 组织成验证树
从候选树、逻辑位置和分支隔离,到按本机成本选择验证规模,拆开投机解码的实现与数值边界。
普通自回归生成一步只确认一个新 token。投机解码试图先用便宜的路径猜几个,再让目标模型检查。KFlash 进一步问:如果只能检查有限的几行,为什么一定要把机会全押在一条链上?
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
drafter、目标模型与 KFlash
Drafter 负责提出候选;目标模型 决定最终接受什么;KFlash 组织候选树、安排验证并估计值得投入多少行。此快照针对不同模型使用 DFlash2、DFlash、LiLiCorr、DSpark 等不同 drafter,验证后端也有差异。
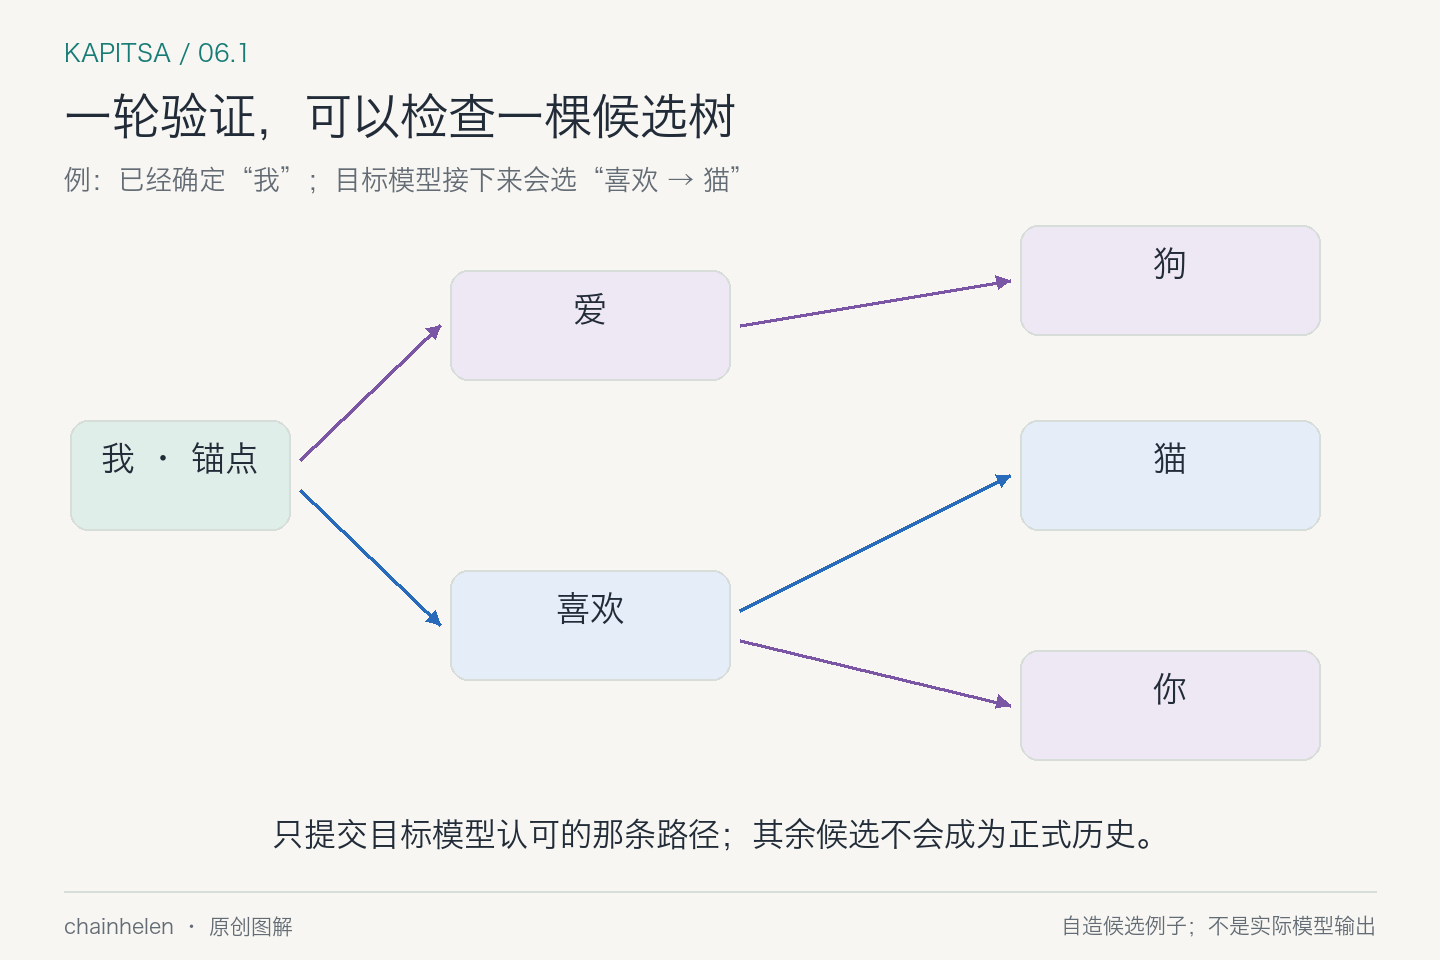
如果只猜一条“我→爱→狗”,目标模型选了“喜欢”,这条链后面的“狗”就帮不上忙。树可以同时保留“爱”和“喜欢”两种后续,甚至给“喜欢”再预留“猫”的下一步。这样一次目标模型验证可能确认更长路径。
代价是验证更多候选、维护分支状态并移动被接受的数据。因此树不是越大越好。先把分支之间的隔离做好,才有讨论性能的基础。
候选树在多行张量中的排列方式
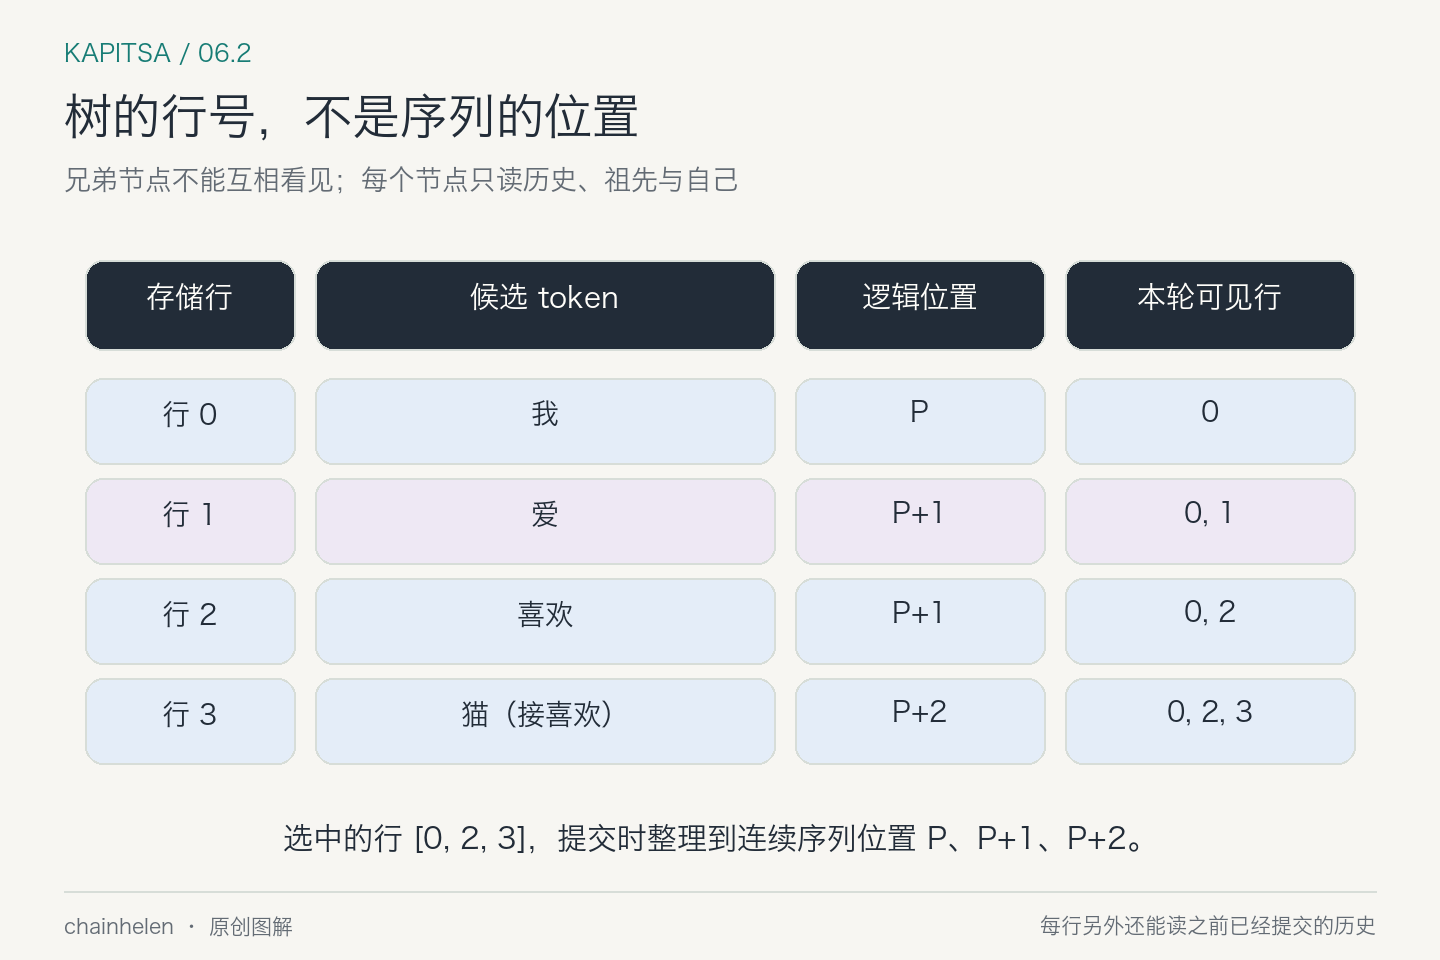
在 共享树描述符 中,每行有 parent、depth、mask 等信息。根行保存锚点;其余行是候选。一个节点的逻辑位置由锚点位置加 depth 决定,而不是“它恰好排在 buffer 的第几行”。
验证时,每行可以看历史、自己的祖先和自己,但不能看兄弟分支。否则“喜欢→猫”的输出会被“爱→狗”污染,已经不是对这个候选序列的正确验证。递归层同样要从父节点的状态继续,而不是机械地接上一行。
Attention 对 Q、K 应用 RoPE 时,使用的是候选 token 在序列中的位置,而不是张量行号;同一深度的不同分支使用相同的位置编号。图中两个兄弟都是 P+1;若给它们不同位置,就改变了所验证的问题。
接受路径的状态提交
kf_accept() 从根开始,寻找 token 与目标模型当前选择一致的子节点,沿匹配分支向下走。没有匹配子节点时停止;随后写入接受路径及末尾 token,保留目标模型在该位置给出的 token 并结束本轮。树决定的是一轮能够前进多远,最终输出仍由目标模型的选择决定。
接受结果还要提交到会话状态中。以 Qwen3.5 为例,树验证与提交约定 指定:encode_kv_tree_compact 将接受路径的 K/V 行整理到连续历史位置;下一次计算或 encode_flush 再提交该路径的递归更新。Seq::pend_path 保存接受路径的行号,确保提交的是树上选中的行,而不是张量的前几行。被拒绝的分支不进入正式历史。drafter 的上下文也按接受路径更新,例如 Engine 的 commit_kept() 调用 encode_commit_path,并在停驻前完成提交。
对采样还要额外小心:单条流的树路径使用目标模型在逻辑位置上的采样结果来匹配候选;普通概率比接受的 speculative sampling 是另一种规则。这个快照的部分批量路径也有自己的采样接受逻辑,不能把“树路径保持相同随机序列”的描述套在所有模式上。
KfBudget:把猜中的收益与验证成本放在一起
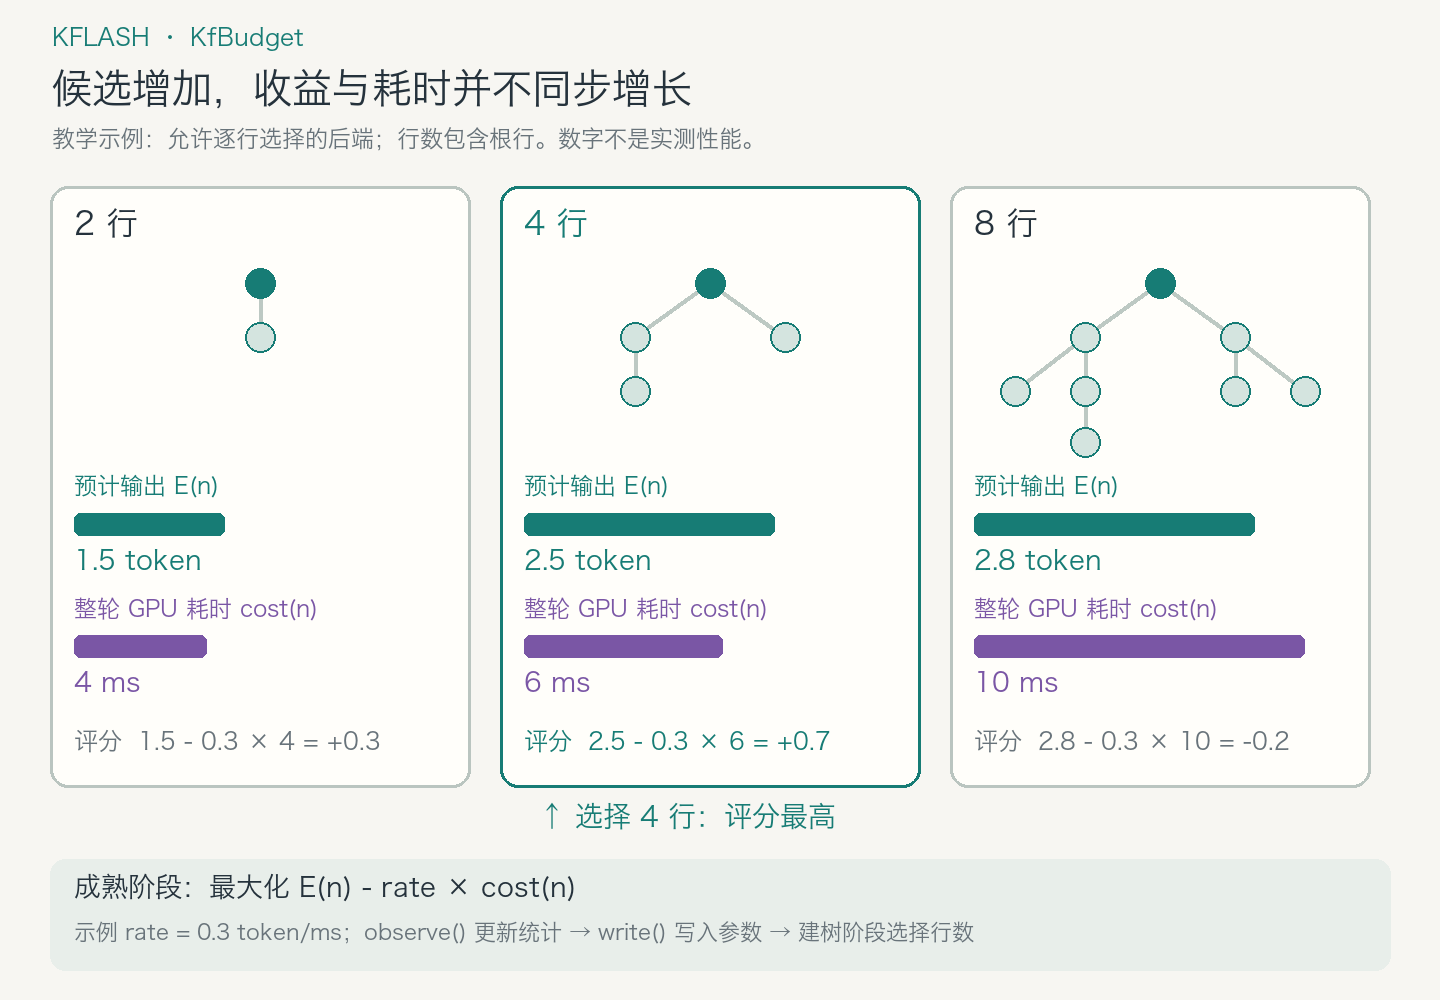
草稿模型给某个词 0.8 的概率,不代表目标模型会以 80% 的频率接受它。KfBudget 的规则说明 用实际接受记录校准这两者的关系,并测量本机不同验证行数的一轮 GPU 时间。
以图中的教学数字为例:验证 2、4、8 行,预计分别输出 1.5、2.5、2.8 个 token,整轮 GPU 耗时分别为 4、6、10 ms。初期比较每毫秒的预计输出:1.5/4 = 0.375、2.5/6 ≈ 0.417、2.8/10 = 0.28,因此选 4 行。有了近期速率后,假设 rate = 0.3 token/ms,评分分别是 1.5 − 0.3×4 = 0.3、2.5 − 0.3×6 = 0.7、2.8 − 0.3×10 = −0.2,仍选 4 行。从 4 行加到 8 行,只多输出预计 0.3 个 token,却多占用 4 ms;按近期速率,这 4 ms 相当于 1.2 个 token 的产出,因此不值得扩大。收益与成本的选择规则 中的 cost 包含猜测和验证两部分的 GPU 耗时。
图中的 2、4、8 行适用于允许逐行选择的后端。后端允许的行数 决定预算能比较哪些方案:dense Qwen 路径按整块验证,可选 8、16、32 行;MoE 路径可以按行选择,但新增行也会增加专家计算。set_rows() / set_wide() 配置这些候选行数与验证容量。如果后端只允许 8 行,预算就不能选择图中的 4 行;支持更宽验证时,才继续比较 16、32 行是否划算。
浮点数值差异可能改变生成结果
看图中的例子:两条路径都在计算“我喜欢”后面的 token。单行 decode 中,“猫”的分数略高;多行验证采用不同的分块或求和顺序,浮点舍入误差使“狗”的分数略高。argmax 只选最高分,于是下一枚 token 不同,后续输入也不同。只有分数接近到会被误差改变排序时,才会出现这种分歧。MoE 挑选专家时,也可能遇到相似的分数排序问题。
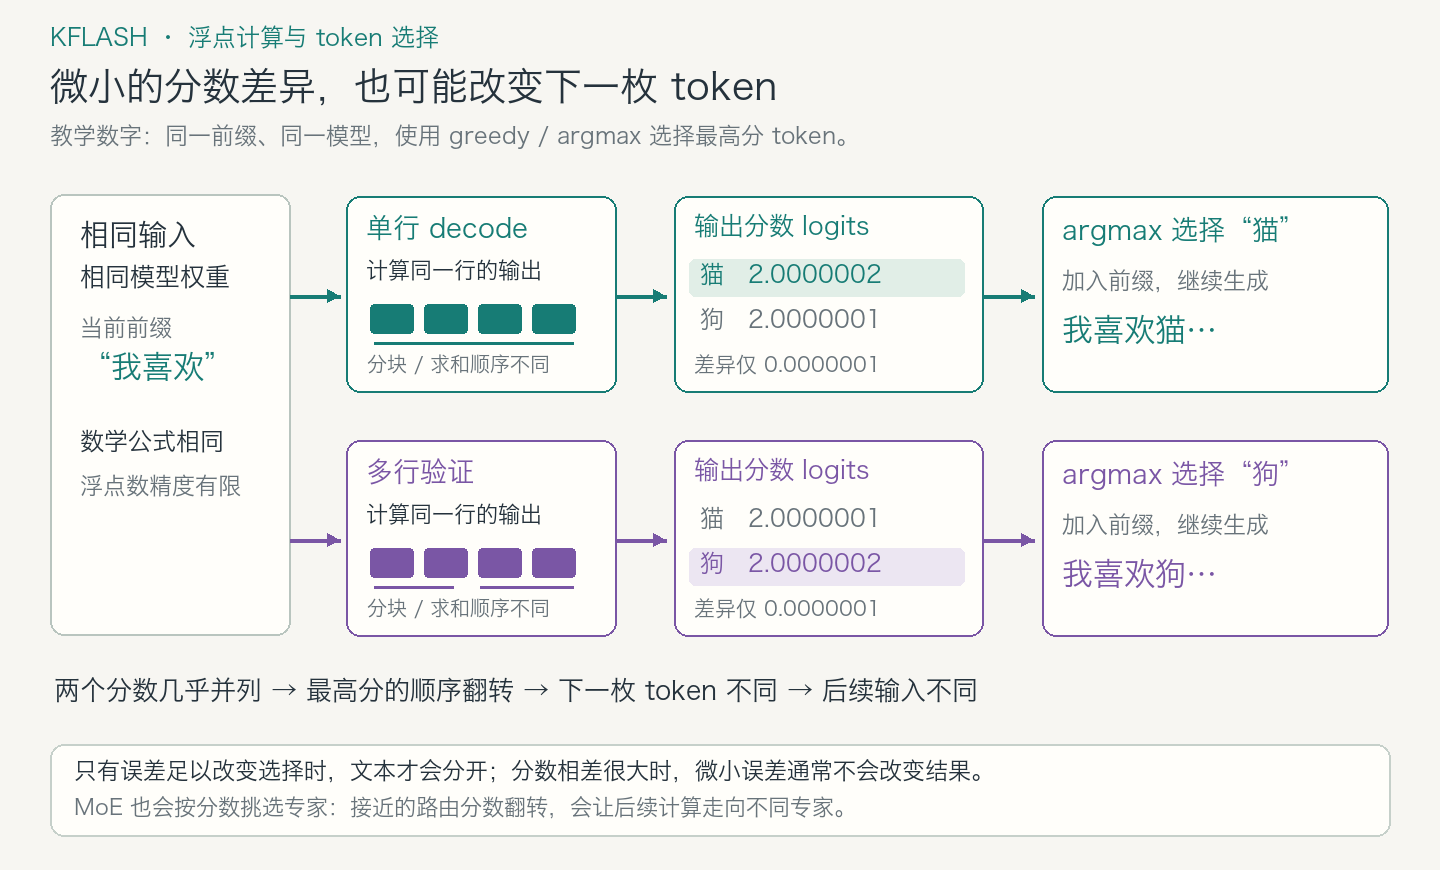
接受规则说明 提到:当两个 token 的分数几乎相同(文中称为 near-tie,即分数接近并列)时,浮点误差可能改变选中的 token。更宽验证和批量验证采用不同的计算路径,也需要检查是否出现这种数值差异。
KFlash 的运行耗时与生成速度对比
测试 KFlash 是否让生成更快,可以在同一台 Mac 上,用相同模型、量化格式、输入和采样参数,分别开启与关闭 KFlash。固定输出长度,再比较实际运行结果。
每轮输出与耗时。 记录每轮实际输出多少 token,以及猜测和验证总共占用多少 GPU 时间。例如,一轮输出从 2 个增到 3 个,但耗时从 10 ms 增到 20 ms,生成速度反而从 200 token/s 降到 150 token/s。KfBudget::observe() 接收每轮接受结果与 GPU 耗时,用于更新预算。
完整生成速度。 比较生成阶段的 token/s、首 token 等待时间和请求总耗时,确认局部收益能否反映到完整请求。Engine::chat 的耗时统计 记录生成阶段的 decode_ms,并分列其他阶段的耗时。同时检查输出 token 和 logits 的差异,避免把数值路径变化误当成纯粹的性能提升。