Kapitsa 源码拆解 05:前缀缓存与模型状态恢复
从精确 token 前缀、混合模型状态到 SSD 的块与快照,解释旧对话如何继续而不必从头重算。
第二轮聊天通常会把旧历史和新问题一起发送给服务器。Kapitsa 根据历史 token 匹配共同前缀,复用对应的 Attention KV 缓存;对 Qwen3.5 的 Gated DeltaNet 层,还要恢复卷积窗口和递归状态,再从可恢复的位置计算剩余输入。记录 token 用于匹配前缀,复用的计算状态能省下prefill开销。
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
Attention 与 Gated DeltaNet 保存的历史不同
本节讲的是保存在统一内存中的运行时状态。Attention 的 KV 缓存、Gated DeltaNet 的卷积窗口和递归状态,都位于 GPU 可访问的 Buffer 中。后文的 SSD 前缀缓存将这些状态持久化到磁盘;恢复后仍需加载回内存,模型计算时不直接查询 SSD。
Qwen3.5 的不同层分别使用 Attention 或 Gated DeltaNet,之后各有 FFN;两者不在同一层串联。Attention 保留历史 K/V,Gated DeltaNet 更新固定大小的递归状态。
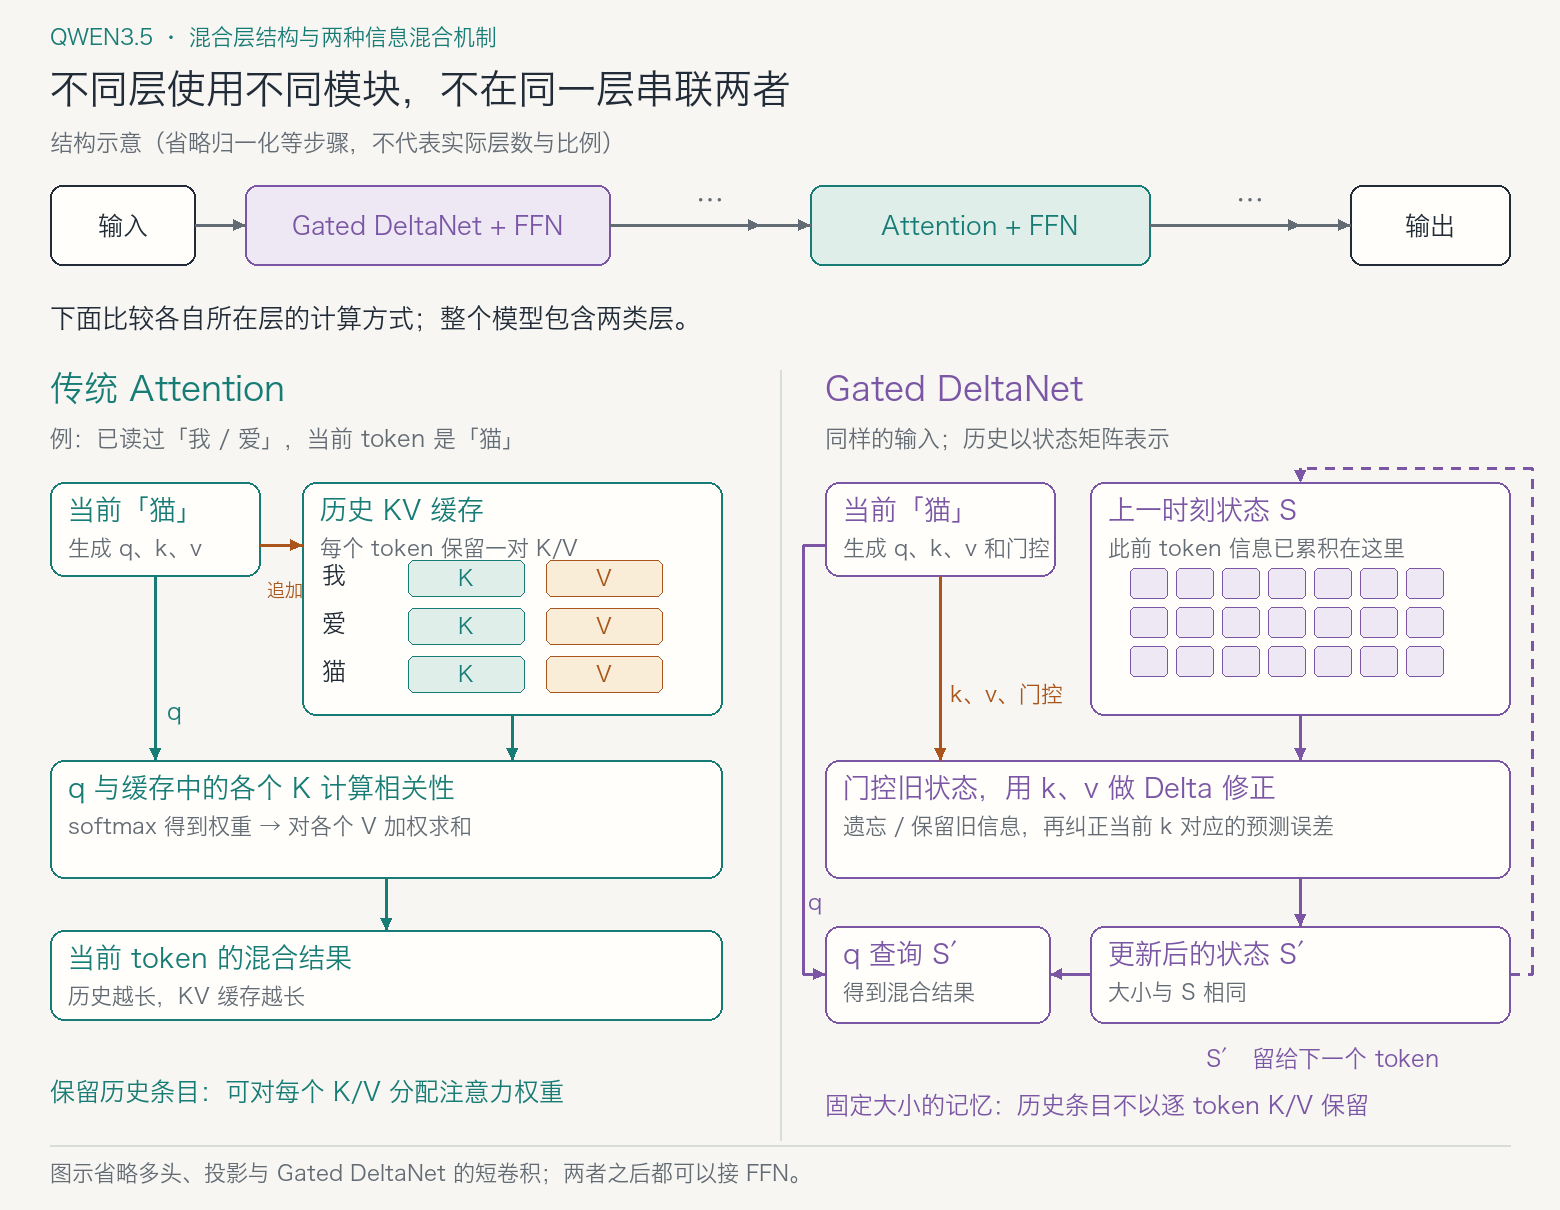
Gated DeltaNet 将历史累积到固定大小的状态矩阵中。新 token 到来时,门控决定旧信息保留多少,k、v 用于修正状态:比较状态对当前 k 预测出的值与当前 v,再按差值更新;q 查询更新后的状态得到输出。它不逐个保留历史 K/V,状态更新的工作量不会随历史 token 数量增长,但历史信息必须通过有限状态表达。
因此,Qwen3.5 的 Attention 层复用 KV 缓存,Gated DeltaNet 层则恢复短卷积窗口 conv 和递归状态 rec。Qwen35::save / restore 可以看到这两类递归层状态如何复制到检查点并恢复。两者必须对应同一个历史位置,才能继续计算。
相同前缀不一定能全部复用
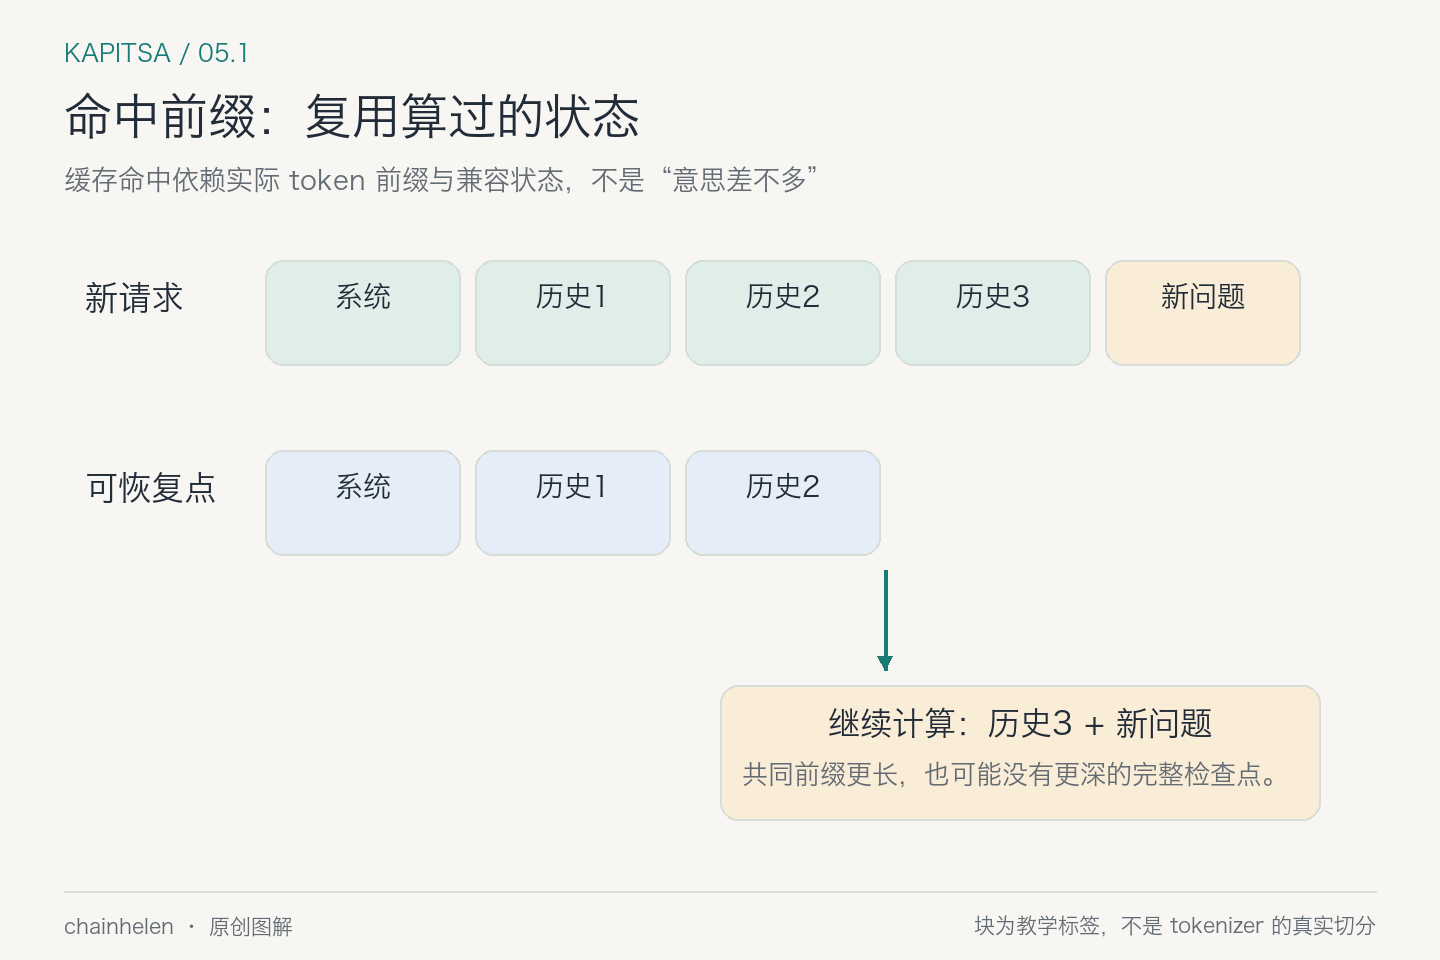
假设新请求前 1000 个 token 与旧请求相同,但完整状态只保存到前 800 个 token 处理完的位置。模型就从这里恢复,重新计算剩余 200 个 token 和新输入。相同的 token 不代表对应的计算状态已经保存。图中的块仅用于示意,不代表实际分词结果。
更不能按语义相似度复用计算状态,缓存查询需要检查精确前缀以及相关兼容条件。例如 “我爱猫”和“我喜欢猫”意思接近,token 序列和中间状态却不一样。
混合架构需要同时保存 KV 缓存和递归状态
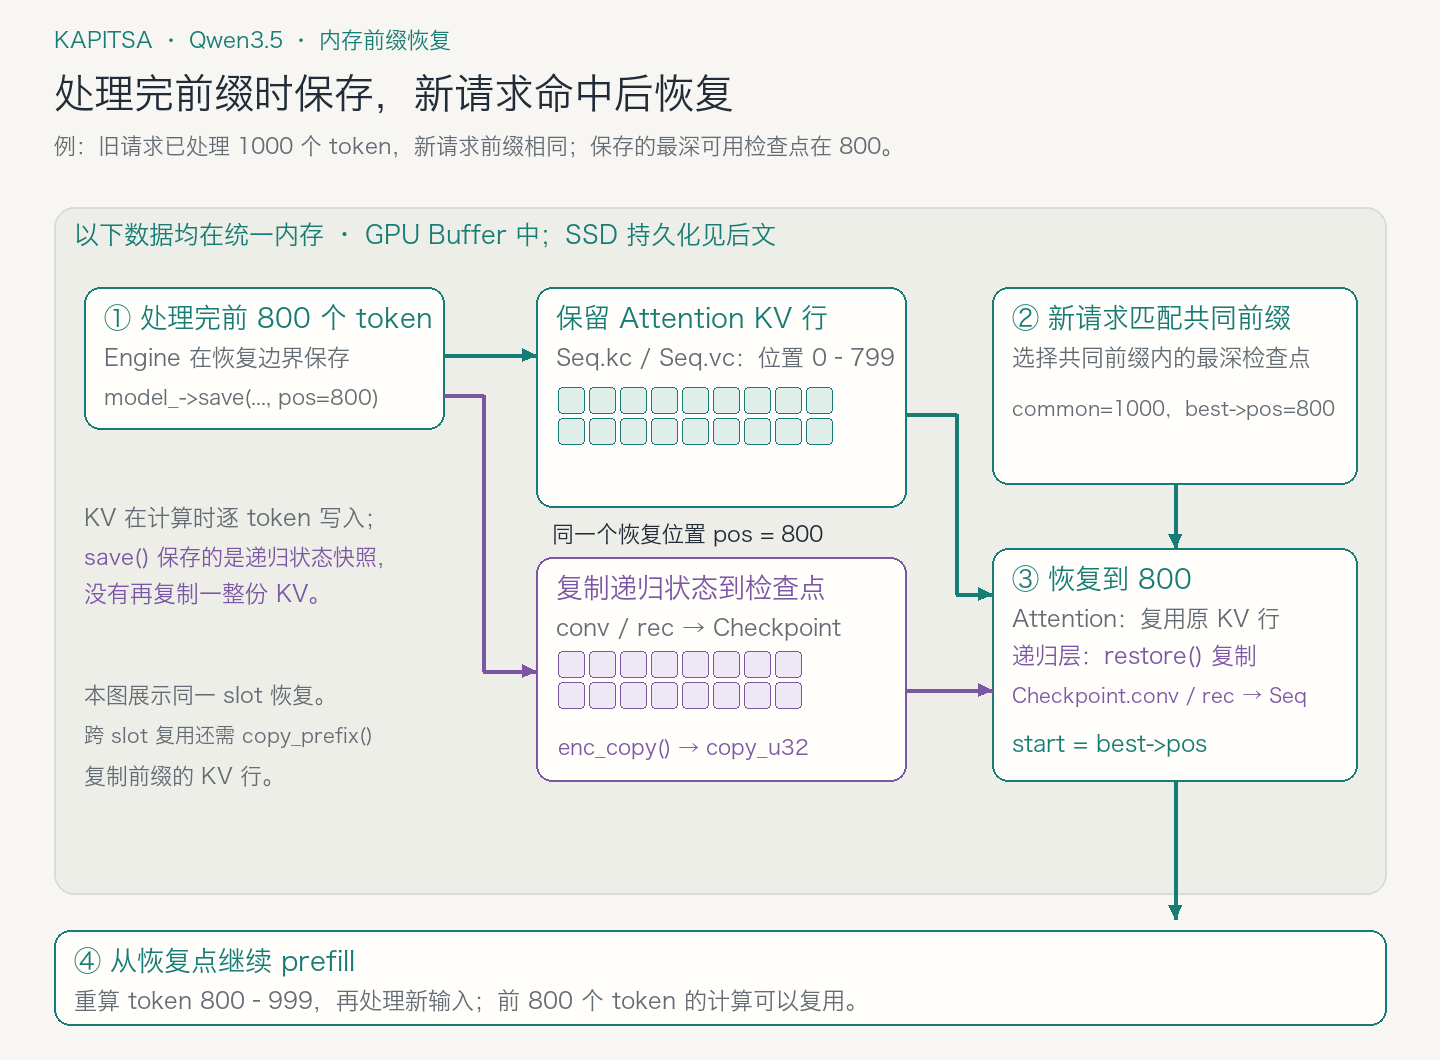
Engine 在前缀或对话边界调用 save 保存检查点。Qwen35::save / restore 用 GPU 复制命令保存、恢复 conv 和 rec;KV 不在这一步另存一整份。新请求匹配共同前缀后,Engine 选择检查点并恢复,从 start 继续计算;跨 slot 的 KV 复制对应 copy_prefix。
KV 缓存保存的是 Attention 的历史键和值。该快照支持的 Gated DeltaNet、Mamba-2 等递归层还需要各自的状态;因此,混合架构的恢复点必须同时包含 Attention 缓存与对应位置的递归状态。
从 Seq 可以看到:kc/vc 对应 Attention,conv/rec 对应递归层;还有尚待提交的投机更新。Checkpoint 则描述某个位置的递归状态快照。
注意力缓存中,已匹配前缀之前的行可以继续有效;递归状态通常需要恢复那个位置的整体快照。使用 drafter 时,还可能需要它自己的上下文环。这些内容必须来自同一个逻辑位置,不能把第 1000 步的 KV 和第 800 步的递归状态拼起来。
SSD 前缀缓存的写入与读取
SSD 是跨请求复用的第二级缓存。写入 SSD 不会自动删除统一内存中的状态。两份可以同时存在;slot 被复用、内存被释放或进程退出后,磁盘副本仍可用于恢复。模型计算始终读取内存中的状态。
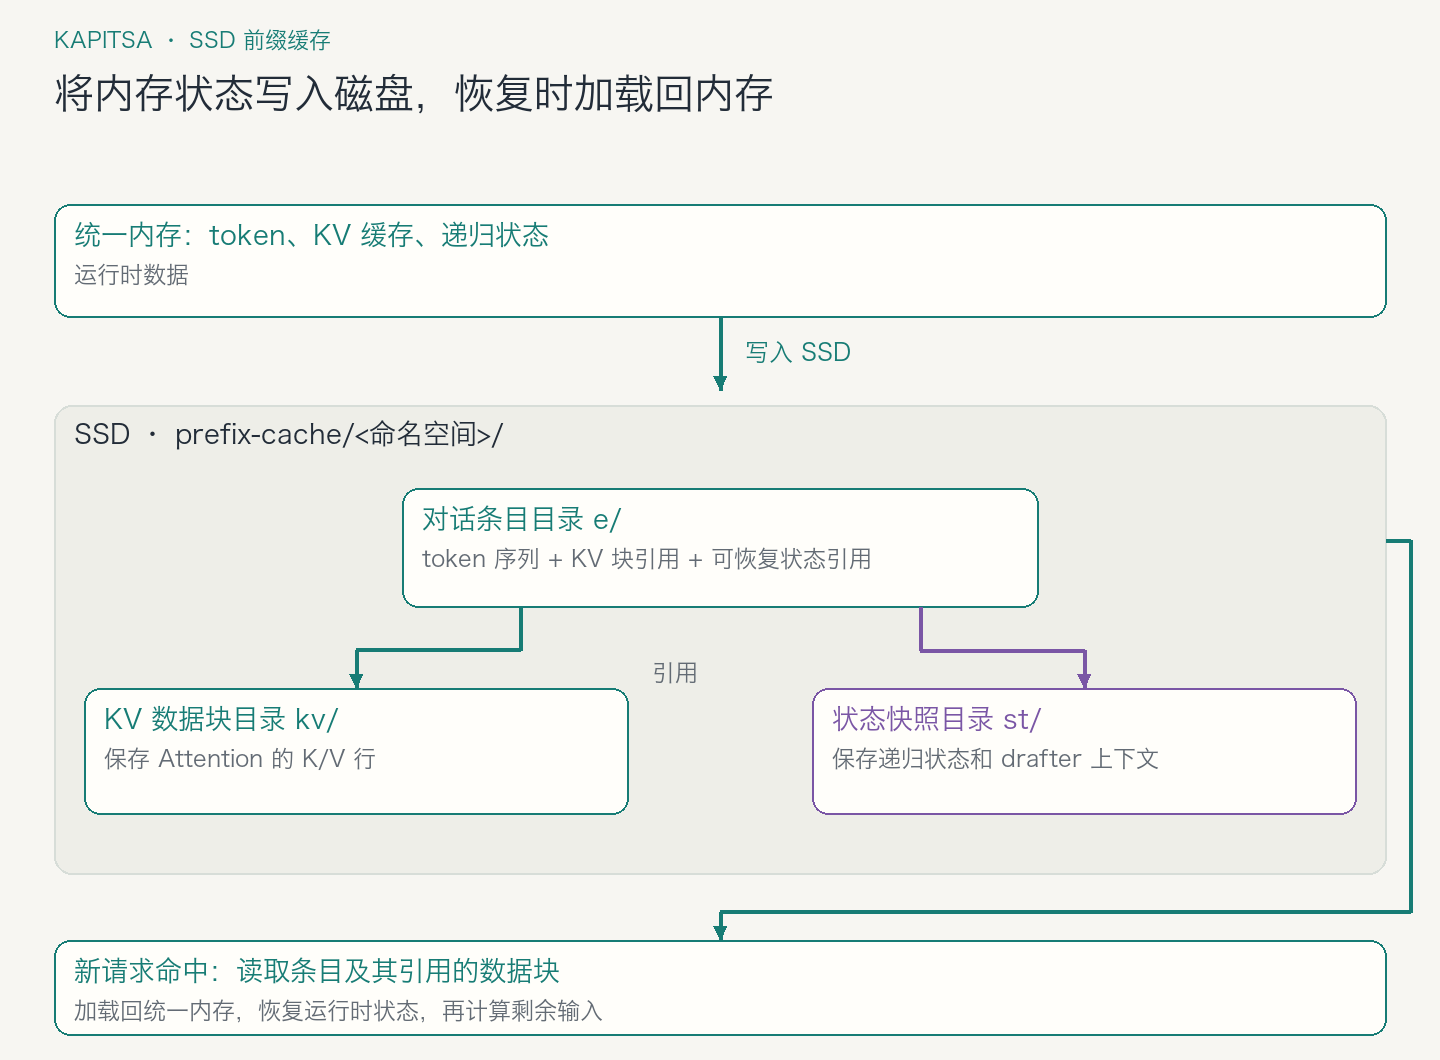
写入:保存会话状态的磁盘副本
slot 是服务器为一段会话保留的内存缓存。数量有限,新会话可能复用旧会话的 slot;旧数据被覆盖前,disk_leaving() 尝试保存尚未写入的状态。
正常运行时也会保存:disk_loop() 在没有活动请求、且一段时间没有新请求时,选择有更新的空闲 slot 写入。服务停止时,save_disk_cache() 在时间预算内补存。后台写入只是保存时机之一。
磁盘数据分为三类:e/、kv/、st/ 文件布局 中,e/ 保存对话 token 和数据引用,kv/ 保存 KV 块,st/ 保存递归状态及 drafter 上下文。对话延长时,条目引用旧块,只增加新的块和状态。
读取:匹配前缀,再加载数据块
新请求到来后,Engine 将 prompt 转成 token,计算内存中可复用的前缀,再调用 disk_lookup() 查找磁盘缓存。查找依据是缓存条目记录的历史 token 与兼容条件,不要求旧 KV 仍在内存中;查找后才读取大块状态数据。
磁盘命中意味着:找到一条前缀匹配、并有兼容恢复点的缓存记录。磁盘上的恢复点若比当前 slot 可复用的位置更深,disk_restore() 就读取条目引用的 KV 块和状态快照,将它们加载到当前 slot 的统一内存中。Engine 的恢复入口 随后从恢复位置继续 prefill 剩余输入。
读取成本与重新计算成本
SSD 不参与每个 token 的 Attention 查询。缓存命中时读取一次所需状态,之后仍在内存中推理。disk_lookup() 的等待策略 会比较排队写入的等待时间与重新 prefill 的成本;disk_restore() 使用最多四个线程并行读取,并在读盘期间让出 GPU turn,允许其他请求继续计算。命中仍有读取成本,实际收益应与重算相同前缀的耗时比较。
缓存复用的兼容条件
- 模型或 drafter 不同:同一 token ID 在不同模型中不意味着相同内部状态。
- 状态布局或格式版本不同:相同字节必须按同一种含义读取。
- 图片内容不同:仅比较文字占位还不够,必须检查图片对应状态。
- 计算历史不同:源码的 KV 块键还记录产生它们的请求信息,以区分相关计算来源。
命名空间 按模型、drafter 和状态布局隔离缓存。其摘要包含模型目录、文件信息、配置校验值、状态格式、解码模式和每块 KV 的行数;使用 DFlash2 时还包含 drafter 的文件信息。文件信息采集 记录文件名、大小与修改时间,并对 config.json 计算 CRC-32C。
KV 块键 包含前一块的键、当前块的位置范围、token ID,以及这段 KV 的计算批次标识。disk_filled() 为每段实际计算生成标识,因此相同 token 在不同计算批次中产生的块可以区分,块键也保留了前缀链的关系。
状态快照键 在对应前缀键上加入快照标志;使用 DFlash2 时,再加入上下文位置和有效范围。它将状态快照绑定到具体恢复点。
磁盘缓存的完整性校验与容量管理
SSD 前缀缓存需要保证两件事:读取的文件完整有效,磁盘占用保持在预算内。Store 分别通过文件校验和容量淘汰处理这两个问题。
完整性校验。Store::write_file() 将数据写入临时文件,记录头部与 payload 的 CRC-32C,写入成功后用 rename 改成最终文件名;失败则删除临时文件。Store::read() 检查文件身份、头部和 payload 校验值,读取失败时通过 drop_damaged() 清理损坏文件及依赖它的缓存条目。CRC 用于检错,不提供加密;文件中的 token 和模型状态仍是可读取的数据。
容量管理。Store::measure() 根据配置配额与磁盘可用空间更新容量上限。空间不足时,make_room() 先清理无引用的数据块,再按最近使用时间淘汰未被固定的缓存条目;pin() / unpin() 保护正在使用的条目,并在使用后更新时间。删除条目时,drop_entry() / unref() 减少其数据块的引用计数,仍被其他条目共享的块会保留。若无法腾出足够空间,本次缓存写入就会失败。