Kapitsa 源码拆解 01:一条请求如何变成 token?
固定 0.2.17 / 919b1b2,从请求、prefill、decode 到会话状态,建立阅读这套原生推理引擎的地图。
把“我爱猫”发给一个本地模型,HTTP 接口收到的只是一份请求。要得到回复,中间还要经过模板、分词、会话状态、矩阵计算、采样和流式输出。Kapitsa 的实现值得拆开读,正是因为它把这些环节连成了一条完整的运行路径。
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
推理引擎
这个快照使用原生 C++20,模型后端把计算编码成 Metal 命令,符合条件的预填充操作可以交给 ANE。它支持一些 MLX 格式权重,但读取同一种权重格式,不等于使用 MLX 运行时。源码的 架构说明 明确区分了两者。
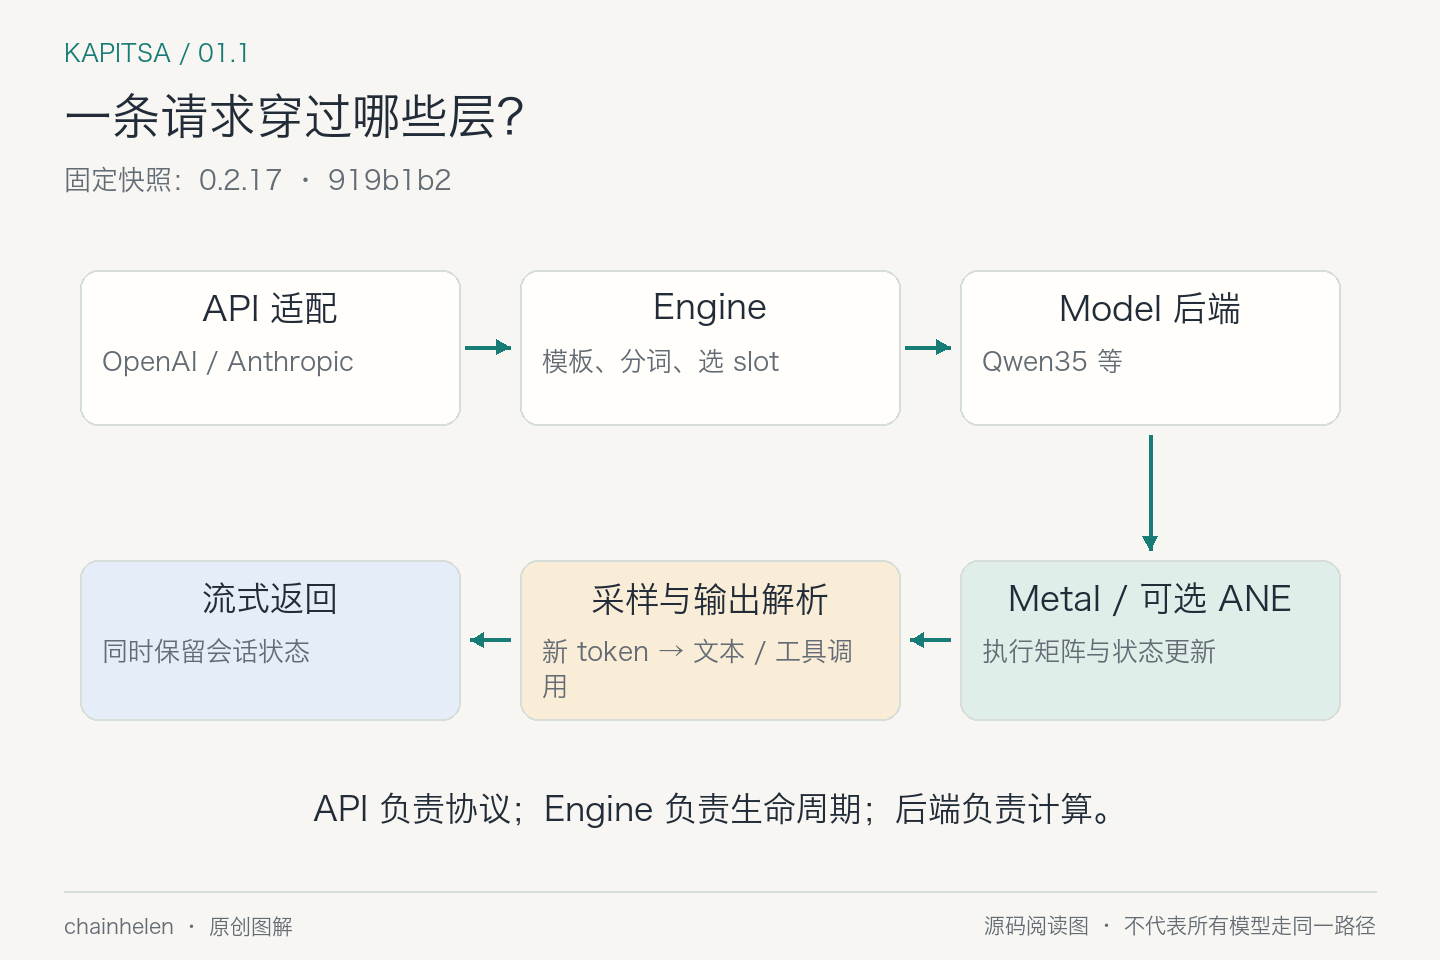
可以把源码分成四个阅读层次:
- API 负责协议;
- Engine 安排请求生命周期;
- Model 后端知道模型的层和缓存;
- Metal/ANE 执行具体任务。
代码框架目录
图 1 画的是职责,打开仓库后还需要找到承担这些职责的文件。这里以 POST /v1/chat/completions 的文本请求为主线:HTTP 入口把请求交给 Engine,Engine 持有具体 Model,并通过 Model 的统一接口安排计算。模型后端再把操作编码到 Metal,支持的路径才会使用 ANE。
src/
├── server/main.cpp       HTTP 路由、请求解析、调用引擎
├── api/                  各种 API 的响应与流式协议
│   └── chat_completions.cpp
|   └── responses.cpp
├── engine/
│   ├── engine.h          Engine、ChatRequest、Slot、TurnLock
│   ├── engine.cpp        模板、选 slot、prefill、生成循环
│   └── output_parser.h   将生成内容拆为正文、推理和工具调用
├── tokenizer/            文本与 token ID 之间的转换
├── model/
│   ├── model.h           Model 接口、Seq、Checkpoint
│   ├── qwen35.h          一个具体模型后端的声明
│   └── qwen35_ane.cpp    该后端的 ANE 接入
├── metal/gpu.h、gpu.mm   Buffer、Encoder 与 Metal 调度
├── kernels/              GPU 执行的计算内核
└── ane/ ANE 调用与 FFN 拆分支持(上述非完整文件树,src/api 也不完全是部 HTTP 逻辑)。这个版本的 Chat Completions 请求解析就在 server/main.cpp;api/chat_completions.cpp 主要处理响应、错误和流式输出格式。
其中 Engine 关心请求什么时候运行、状态能复用多少、何时结束;Model 关心给定 token 与状态,如何执行模型的一次计算。因而读请求流程先看 Engine,读某层矩阵怎么计算再进入具体模型后端。
Chat 入口
- 把请求中的消息按该模型的聊天模板组织成 prompt。角色标记、工具描述等也会影响最终序列。
- 把 prompt 分成 token ID。教学图中的“我、爱、猫”只是便于追踪的三个位置,不能直接当作真实分词结果。
- 找到可用 slot,并检查已有历史能复用到哪里。
- 只对没有可复用状态的后缀执行 prefill,然后进入生成循环。
在 Engine::chat 中
text = render(r, true);
base = render(r, false);
// ...
std::vector<int> prompt = tok_.encode(text, prefix_ok ? base.size() : std::string::npos, &boundary);
render 先把消息组织成模型要读的文本,tok_.encode 才把文本变成 token ID。随后 pick_slot 比较可用 slot 的历史与检查点,选择可复用状态;这里只匹配一段文字还不够,必须有对应的模型状态。
“我的问题只有十个字”不等于模型只处理十行;系统提示和之前的对话也在序列里。另一边,序列很长也不一定需要从头计算:命中的前缀可以减少本次工作量。
Prefill 与 decode
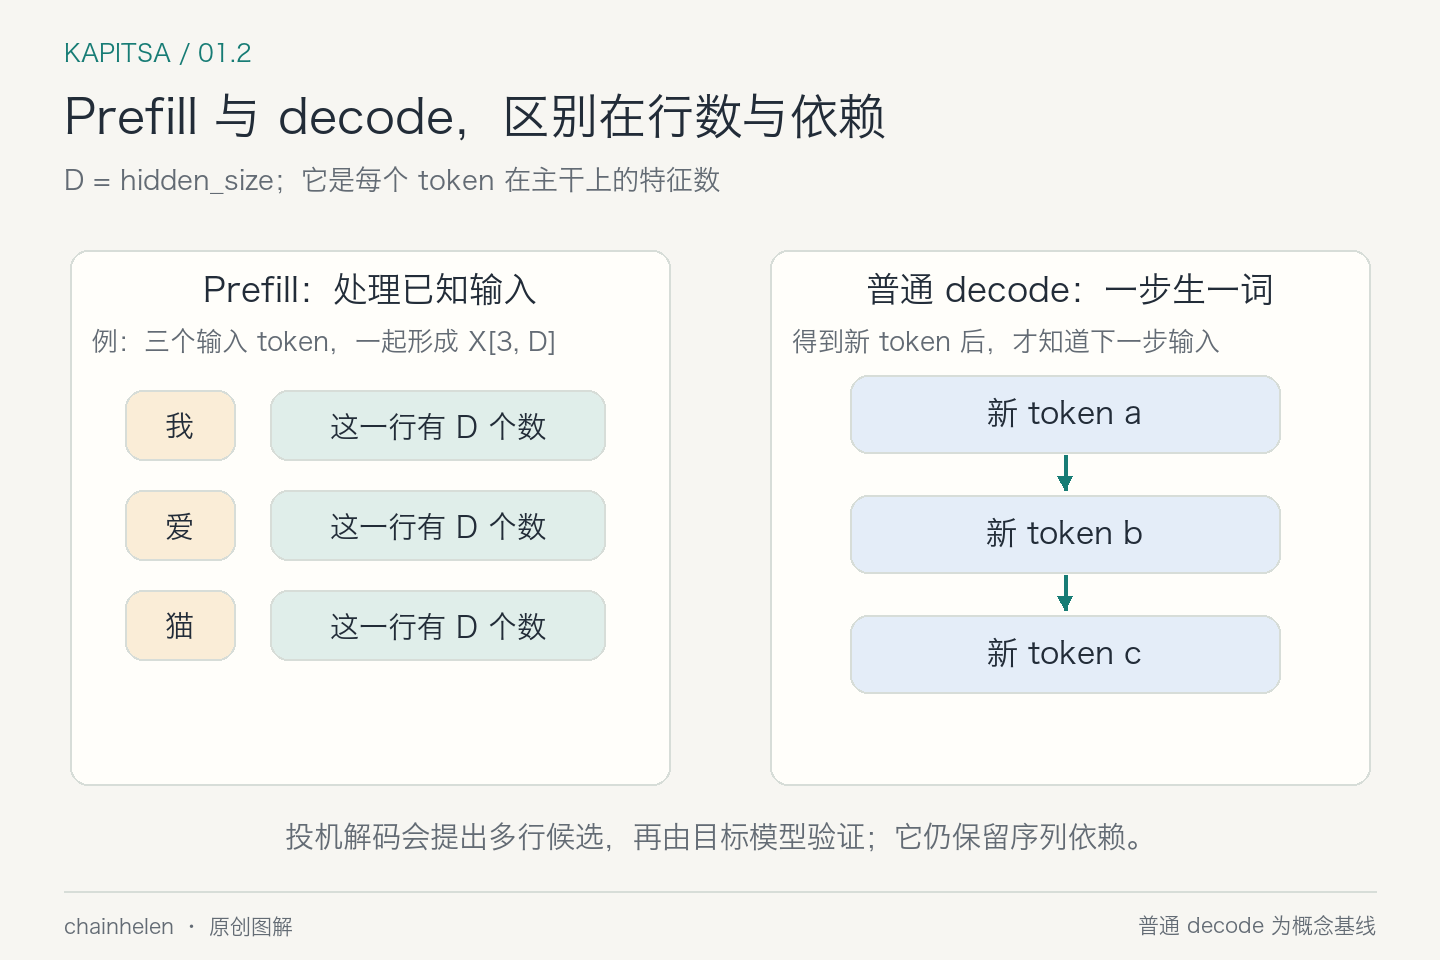
Prefill 处理已经知道的输入,建立后面生成需要的状态。假设本次处理 T 个 token、隐藏维度为 D,主干输入可以看成 X[T,D]。注意 D 是每个 token 的特征数,即不是网络层数也不是权重大小。
普通 decode 每次根据现有历史得到下一个 token,再把新 token 作为下一步输入。因此它有顺序依赖。(当然Kapitsa 的投机路径会一次提出多个候选,再让目标模型验证。这是后面第六篇讨论的加速手段)
这两阶段在 Model 接口 上也分开了:
// 源码接口摘录:一次普通生成步骤
virtual void encode_step(Encoder& e, Seq& s, int pos,
    const SamplingParams& sp, uint32_t step, bool sample = true) = 0;

// 一段已知输入的预填充
virtual void encode_prefill(Encoder& e, Seq& s, int pos0, int T,
    const SamplingParams& sp, uint32_t step, bool sample,
    Checkpoint* snap = nullptr, int snap_row = 0) = 0;
Seq& s 是要更新的会话状态;prefill 的 pos0 和 T 表示从哪个位置开始、这次处理多少行。Engine 的 prefill 路径 调用 model_->encode_prefill(...);普通生成分支在 decode 路径 调用 model_->encode_step(...)。这些是“编码计算命令”的入口,不代表调用一结束 GPU 就已经算完;提交和同步还属于执行路径的一部分。
同一个数学投影,在多行 prefill 和少行 decode 中的权重复用机会不同。(后端会为这些形状选择不同路径,详见第二篇矩阵形状)。
代码中的“会话”
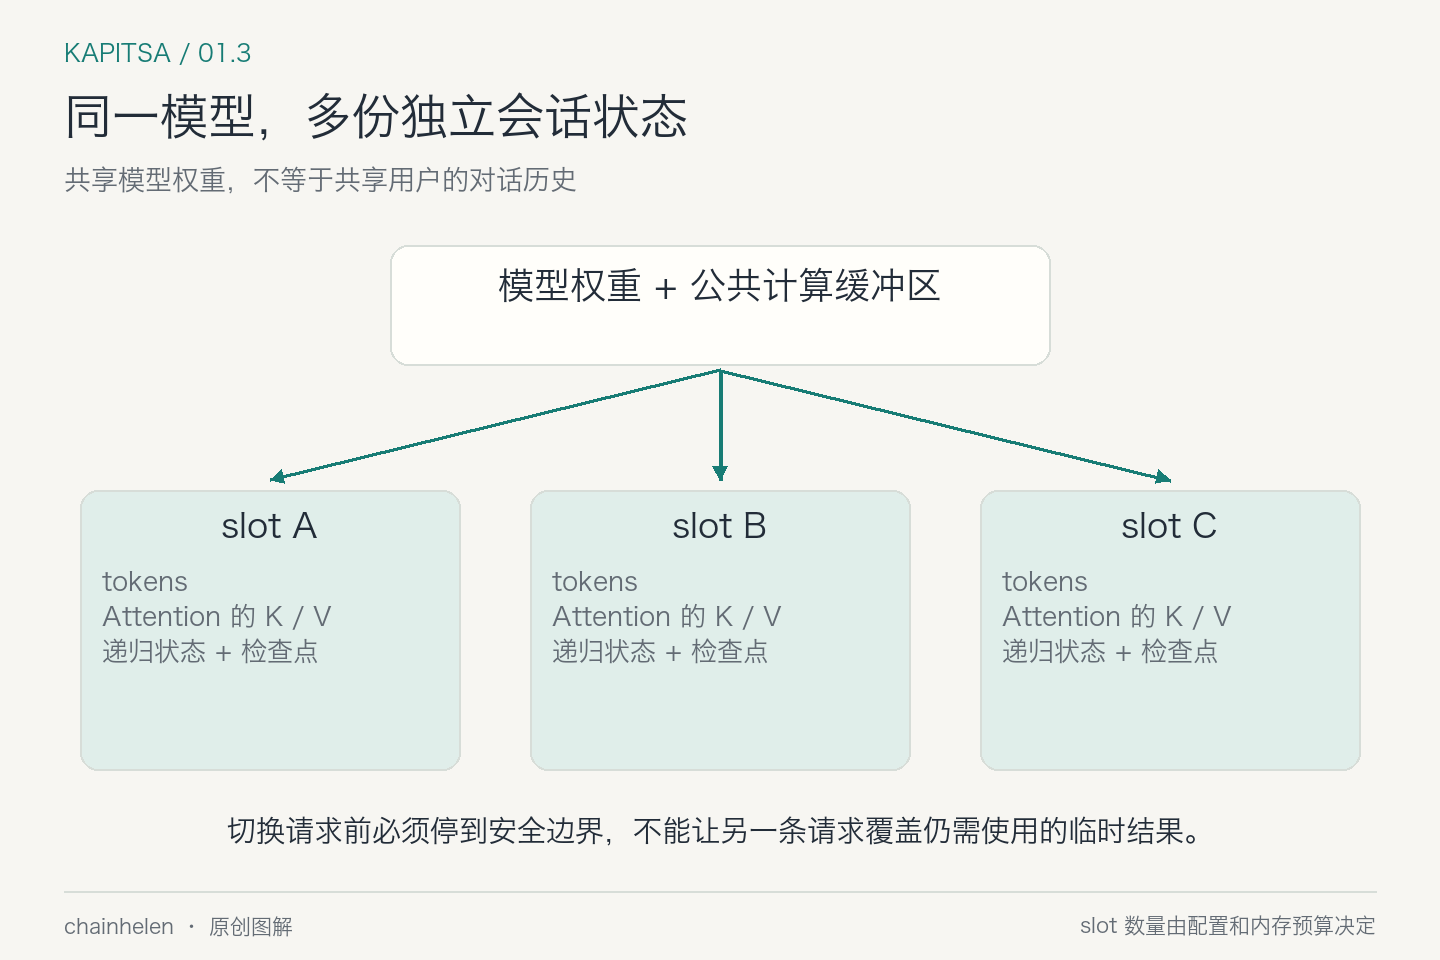
在 Seq 中,可以直接看到 tok、kc/vc、conv/rec 等字段。前者是 token 数据,K/V 属于注意力缓存,conv/rec 则服务于 Gated DeltaNet、Mamba-2 这类带状态的层。
把图 3 对回 Engine::Slot,可以看到以下字段(源码节选,省略 drafter 与其他记账字段):
struct Slot {
  std::unique_ptr<Seq> seq;
  // ...
  std::vector<int> tokens;
  // ...
  std::vector<TurnCheckpoint> ckpts;
  // ...
  bool busy = false;
  // ...
};
seq 指向实际模型状态,tokens 用来跟新 prompt 比较历史,ckpts 留下可恢复的位置,busy 表示这个 slot 正被请求使用。图里的“独立会话”对应的是这些对象,而共享的模型由 Engine 管理。
Engine 的 slot 在这些模型状态之外,还管理检查点、生成器上下文和请求进度。多个请求能够共用模型权重,但不会将历史状态混在一起。(SSD 缓存篇会详细拆解)
抢占GPU
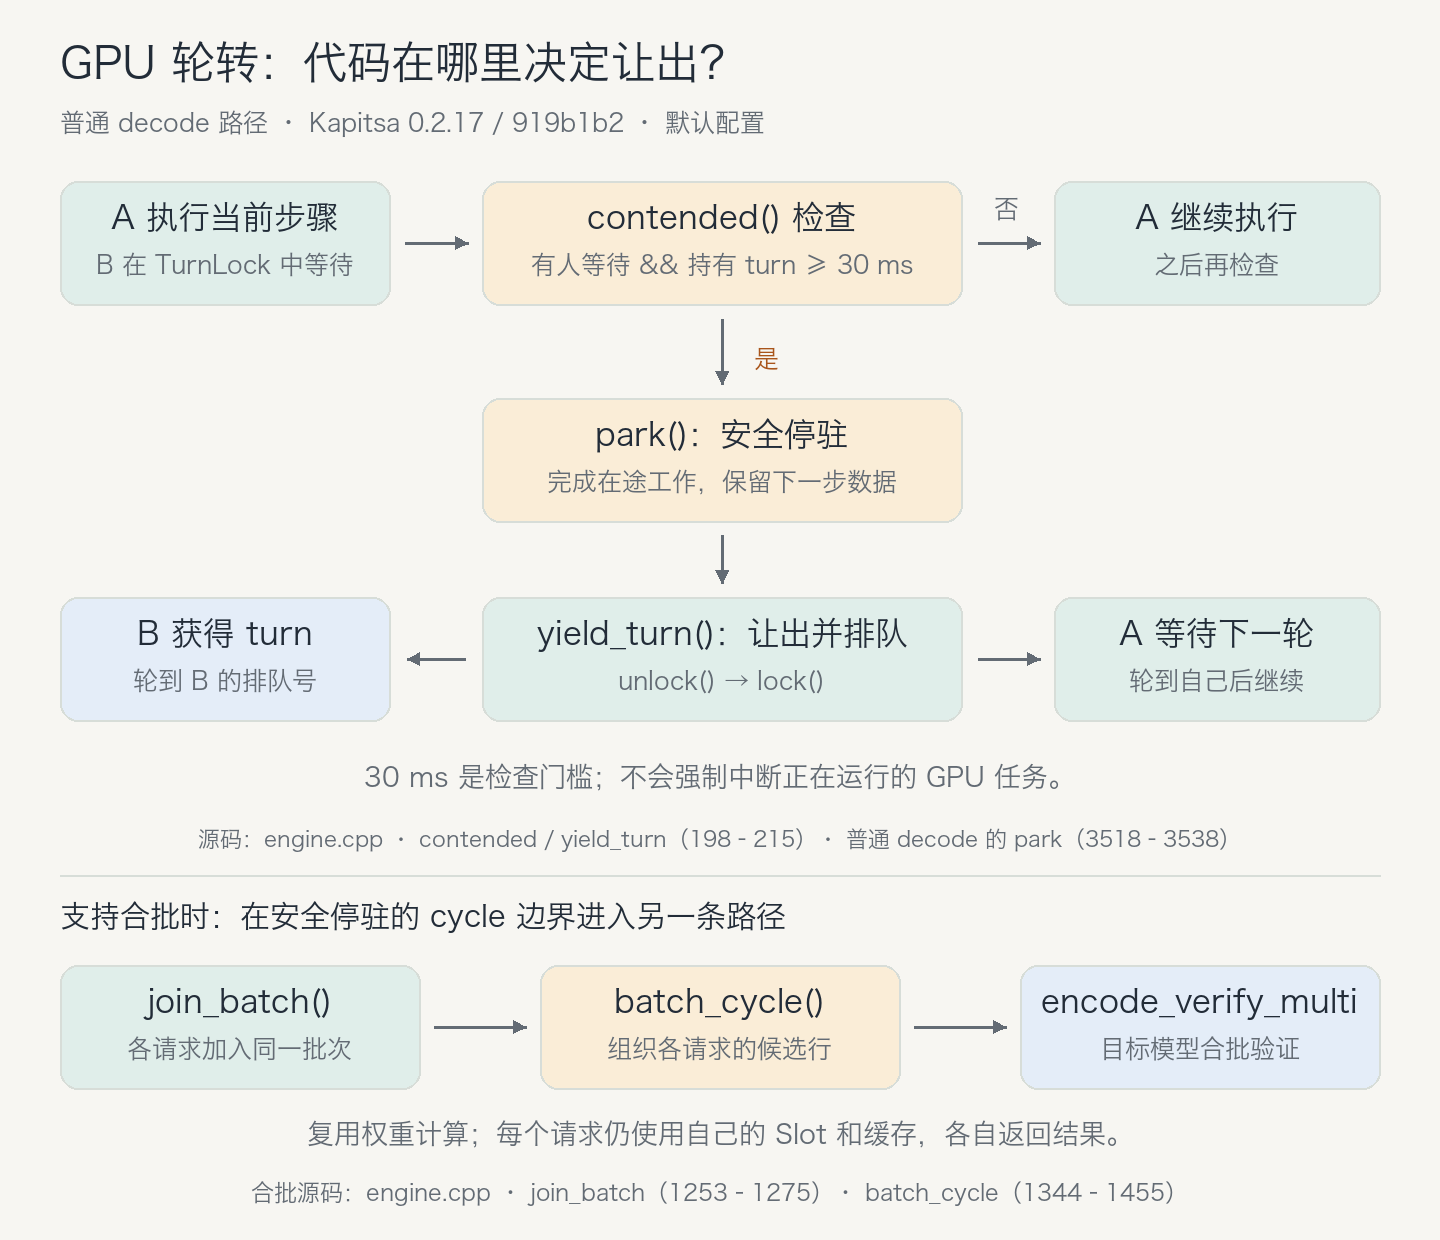
- 多个请求同时到达时,Kapitsa 先让它们排队轮流使用 GPU。普通 decode 路径通过 TurnLock 与 contended() 检查:若有请求等待,且当前请求已持有 turn 至少 30 ms,就在允许切换的步骤边界主动让出;不会到时强行中断 GPU 任务。
- 让出之前,必须先保住当前请求的状态。其他请求会复用公共临时缓冲区,因此当前请求要完成在途计算,并安置下一步还要用的数据。源码中的顺序是 park() → yield_turn():先安全停驻,再释放 turn 并重新排队。
- 图中的“支持合批”,指模型与 drafter 组合已实现多请求批量验证路径。多个请求各自生成候选 token,目标模型将它们对应的输入行合成一批验证,让一次权重读取服务于多组输入;未实现这条路径的组合仍然轮流执行。具体适用组合见该版本的并发说明。请求通过 join_batch() 入批,batch_cycle() 调用
encode_verify_multi执行验证;每个请求仍通过自己的 BatchJob 关联独立Slot,各自维护缓存、保留通过验证的 token,并返回各自的结果。