Kapitsa 源码拆解 02:权重、矩阵与 Metal
用明确的矩阵形状和字节算例,理解量化权重、Buffer 视图,以及统一内存为什么仍需要同步。
本篇沿着一次矩阵乘法 Y = XWᵀ 读源码:先区分输入 X 与权重 W,理解多行 prefill 和单行 decode 的读取开销;再看量化权重怎样存储;最后追踪这些数据如何通过 Buffer 和计算命令交给 GPU 执行。
版本范围:本系列固定阅读 Kapitsa 提交 919b1b2a6782ec205e23725dee76ee5f57de2857;该快照的 CMakeLists.txt 标注版本为 0.2.17。以下是源码拆解与教学算例,不是本机性能实测;其他版本的默认参数和实现可能不同。
矩阵乘法中数据和参数
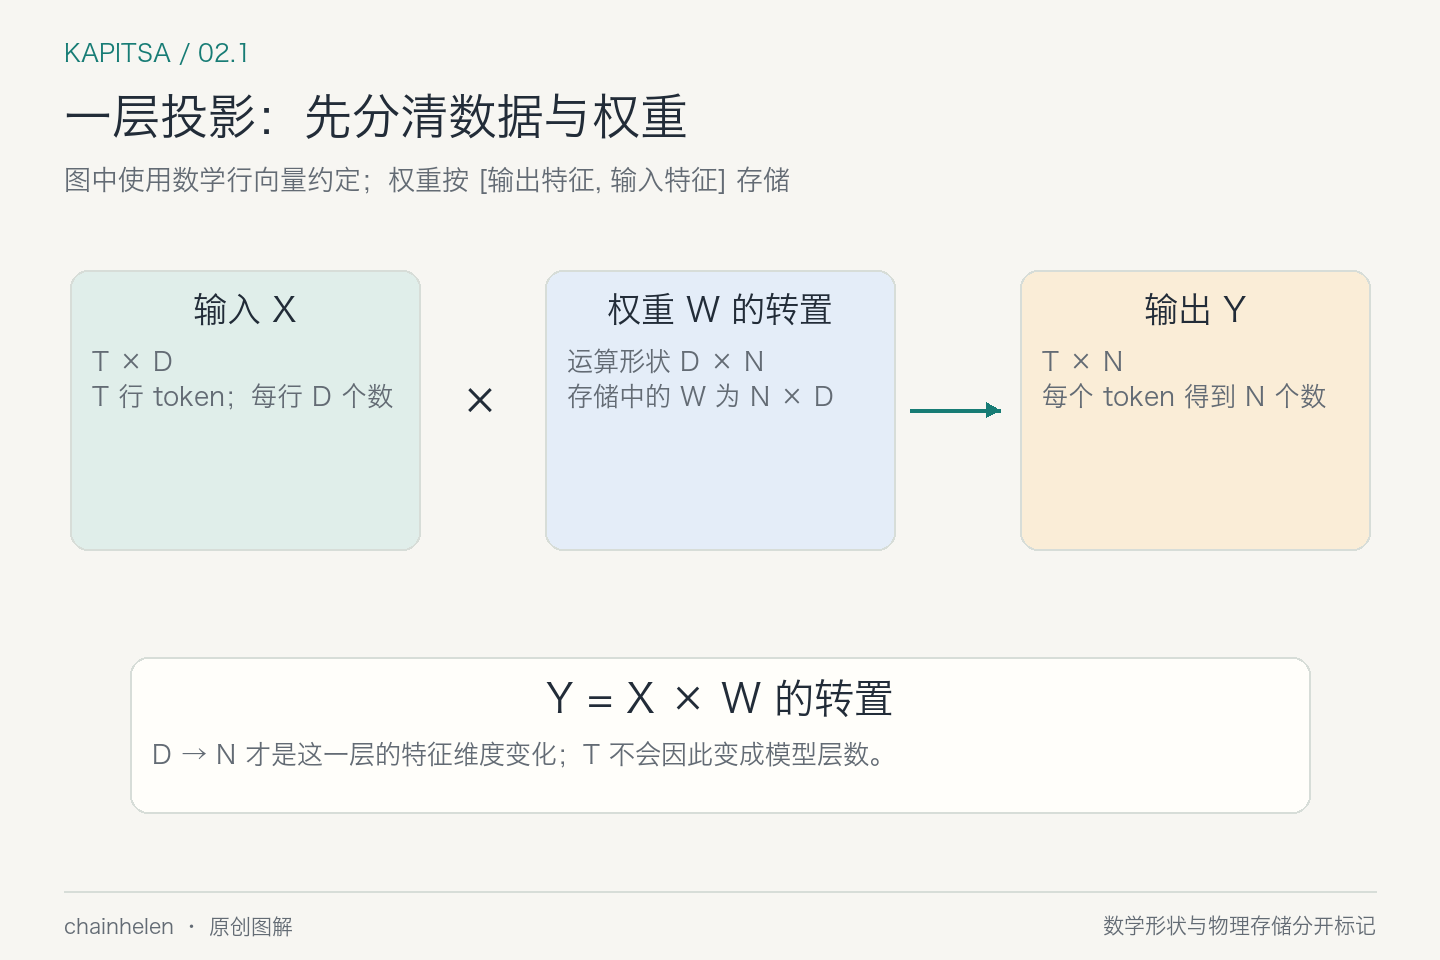
本文采用行向量约定:X[T,D] 是本次输入,权重按 W[N,D] 保存,于是 Y=XWᵀ,输出是 [T,N]。W 的每一行负责一个输出特征;X 的每一行负责一个 token。
这里需要区分两个维度:
- D:主干隐藏维度。比如
D = 5120,表示主干中每个 token 的向量有 5120 个数。 - N:FFN 中间维度。配置或论文中也常写成
intermediate_size或d_ff。FFN 将向量从 D 维映射到 N 维,计算后再映射回 D 维。
只有 N > D 时,D → N 这一步才是升维。“隐藏层”指网络中的层,“隐藏维度”指向量长度;5120 描述的是向量长度,不是网络层数,也不表示已经发生了升维。
Prefill 一次处理多行输入,GPU 可以读入一块权重,再用它计算多个 token,使权重读取的开销被更多计算分摊。普通 decode 每步只有一行输入,同样要访问大量权重,却缺少这种复用机会,因此常受内存带宽限制。GPU 后端会为两种形状安排不同的线程分工:多行时侧重分块和权重复用,单行时侧重并行读取权重与求和。
前面说明了权重如何参与计算,接下来要看它在内存里是什么样子。普通 decode 的权重读取可能成为瓶颈,因此压缩权重能减少需要读取的数据量。Kapitsa 支持量化权重,但“4-bit”主要描述权重数值的编码位宽;存储时还需要额外的量化参数,不能直接把整个权重文件的大小算成“参数数量 × 4 位”。
权重怎样存储:4-bit 编码与额外的量化参数
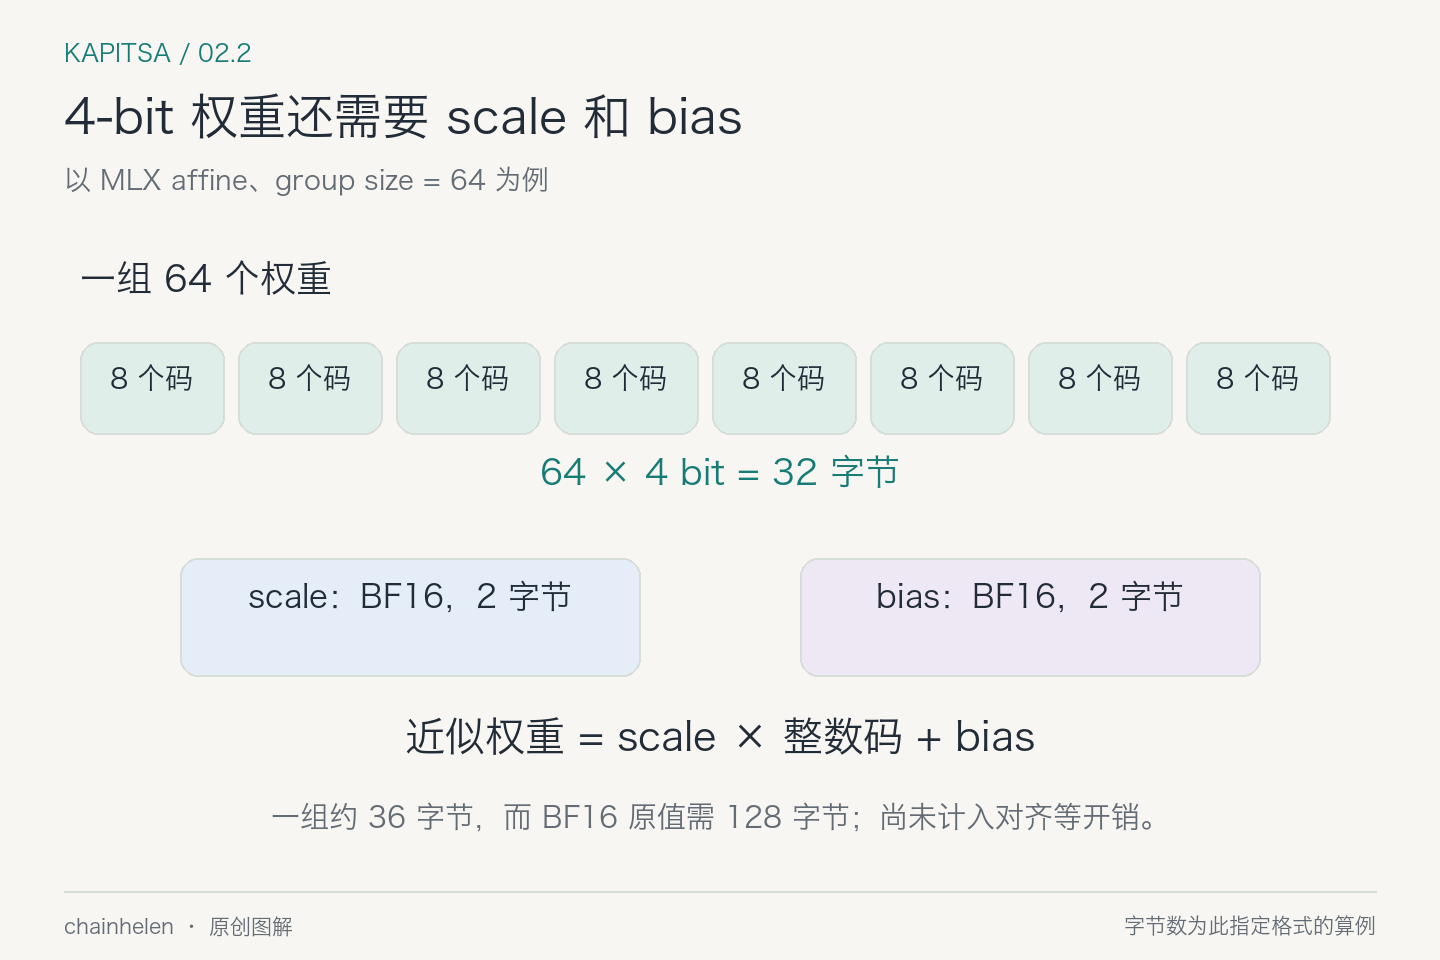
在 权重格式说明 里,affine 格式用整数码 q 加上每组的 scale、bias 表达近似权重:w≈scale×q+bias。这些 scale/bias 也要占空间。
例如一组 64 个 4-bit 码需要 32 字节,两个 BF16 元数据各需 2 字节,总共约 36 字节。与 64 个 BF16 值的 128 字节相比,数据表示约缩为原来的 28.1%,但还没算 padding、其他张量和运行时开销。“4-bit 模型”不会自动意味着整个进程内存刚好降到四分之一。
用一组很小的自造值理解反量化:若 scale=0.25、bias=−1,q=[0,3,8,15],得到的近似值就是 [−1,−0.25,1,2.75]。整数码是存储表示,参与后续乘加的数还要遵循内核所采用的转换与累加精度。
源码中的 wf_extract / wf_codes16 用移位与掩码抽取打包值。比如一个 32-bit word 可以容纳 8 个 4-bit 码。
把数据交给 GPU:Buffer 如何描述内存
量化格式决定了权重以哪些字节存储,以及计算时如何解包。接下来要把这些字节交给 GPU:模型后端需要定位输入、权重和输出各自所在的内存区域,再把它们绑定到计算内核。Kapitsa 用 Buffer 表示这些内存区域。
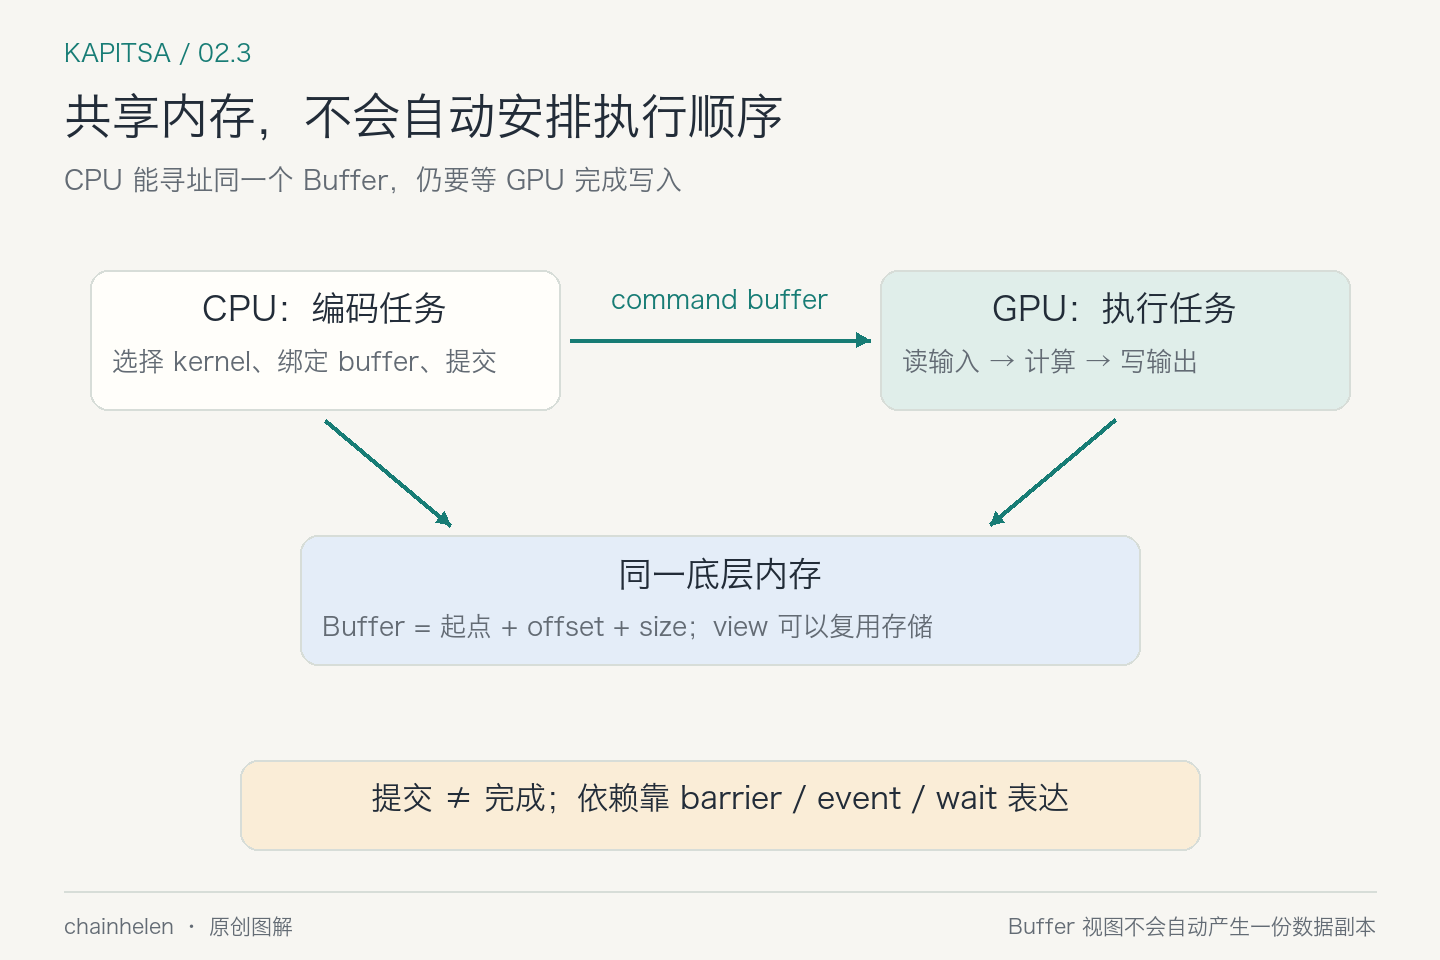
看 Buffer 定义:它保存 Metal 对象、CPU 地址、offset 和 size。view() 返回同一底层 buffer 的另一段视图,不会自动复制数据。一个映射进来的权重文件可以由多个这样的视图表示不同张量。
Gpu::alloc / wrap 都使用 Metal 的共享内存模式(MTLResourceStorageModeShared):alloc() 分配新内存,wrap() 将已有内存包装成 GPU 可用的 buffer,不复制数据。这里的 storage 指 buffer 的内存存储模式,不是磁盘或 SSD 存储;即使已有内存来自权重文件的映射,GPU 访问的也是映射后的内存区域。“共享”表示 CPU 和 GPU 都能访问这块内存,但不保证 GPU 已经完成计算。CPU 要读取计算结果,仍需等待相关 GPU 任务完成。
C++ 代码如何提交 GPU 计算
前面的 Buffer 解决了“数据在哪”的问题,接下来要安排“用哪些数据、执行哪段计算、什么时候开始”。C++ 模型后端在 CPU 上通过 Metal 接口组织计算命令;GPU 执行的是这些命令指定的内核,而不是直接执行 C++ 程序。
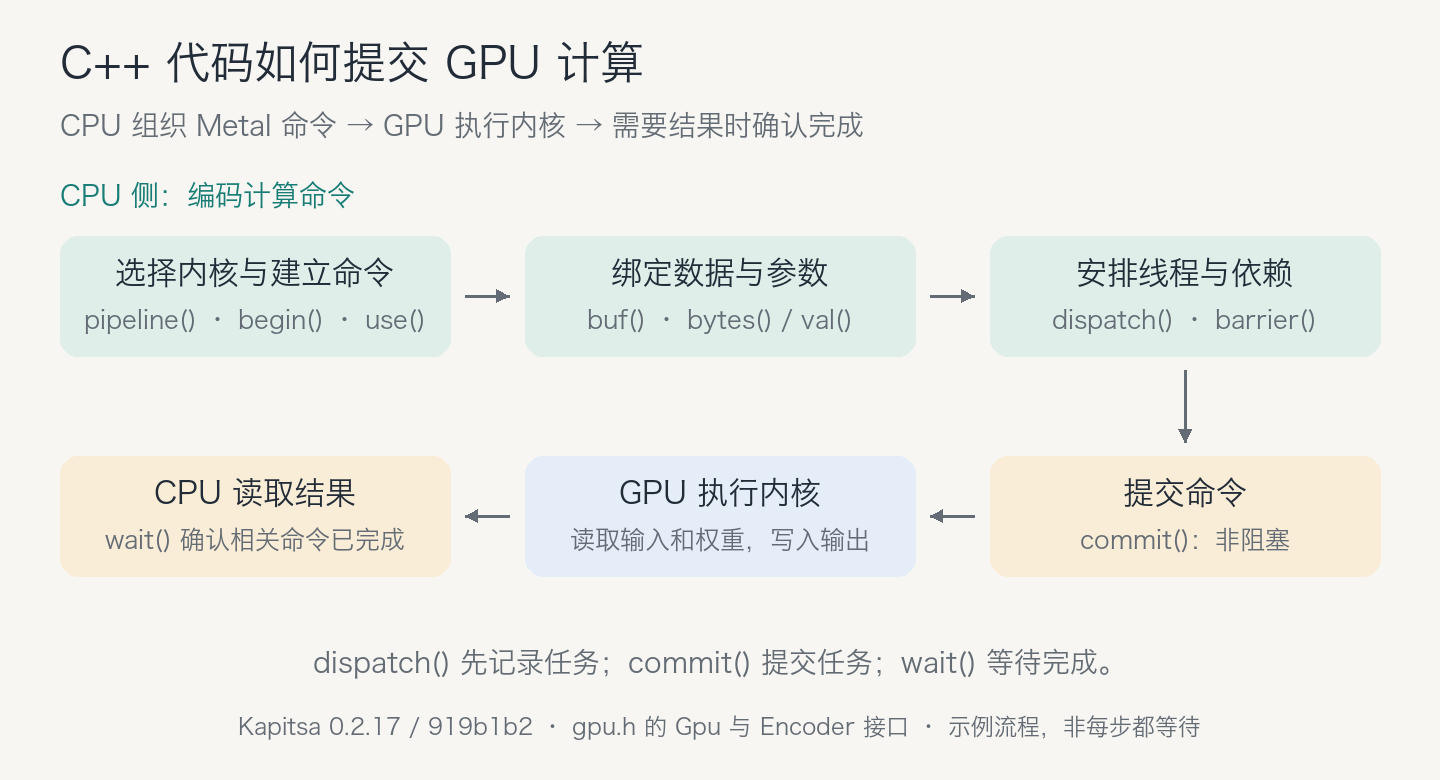
- 选择内核并建立命令。Gpu::pipeline / begin 取得计算管线并建立 encoder,Encoder::use 选择本次使用的内核。
- 绑定数据与参数。Encoder::buf / bytes / val 绑定输入、权重、输出的 Buffer,以及形状等参数。
- 编码线程安排与依赖。Encoder::dispatch 记录线程组和网格;并发命令之间有数据依赖时,通过 barrier() 建立屏障。此时任务尚未因 dispatch 调用而立即完成。
- 提交给 GPU 执行。Encoder::commit 结束编码并提交 command buffer;提交是非阻塞的,CPU 可以继续组织后续工作。
- 需要读取结果时确认完成。Encoder::wait 等待相关命令完成;共享内存本身不提供这个完成保证。
这一套封装的价值,是让模型后端可以组合细粒度 kernel,而不必在每一步都回到 CPU 等待。Encoder 附近的接口注释 也明确区分了非阻塞提交与依赖屏障。具体等待方式要看调用点,不能简单地把所有共享 buffer 都当成随读随写。
优化 kernel 后,要检查请求耗时与数值结果
kernel(GPU 计算内核)指在 GPU 上执行一项计算的程序,例如量化矩阵乘法、归一化或注意力计算。在 Kapitsa 中,这些程序主要写在 src/kernels/*.metal;C++ 后端通过 pipeline 选择编译后的内核,再绑定数据并提交执行。它不是操作系统内核,也不是完整模型。
“某个 kernel 执行更快”还不足以说明整个请求更快。评估改动至少要回答两个问题:省下的时间占完整请求多少?计算结果有没有发生变化?
1. 投影 kernel 优化只影响请求中的部分计算
一个请求包含模板与分词、模型各层计算、采样和输出。这些解包步骤可对照 wf_extract / wf_codes16。CPU 读取结果前的等待则可对照 Encoder::commit / wait。这些开销不会因为其中一个计算内核加速而全部消失。
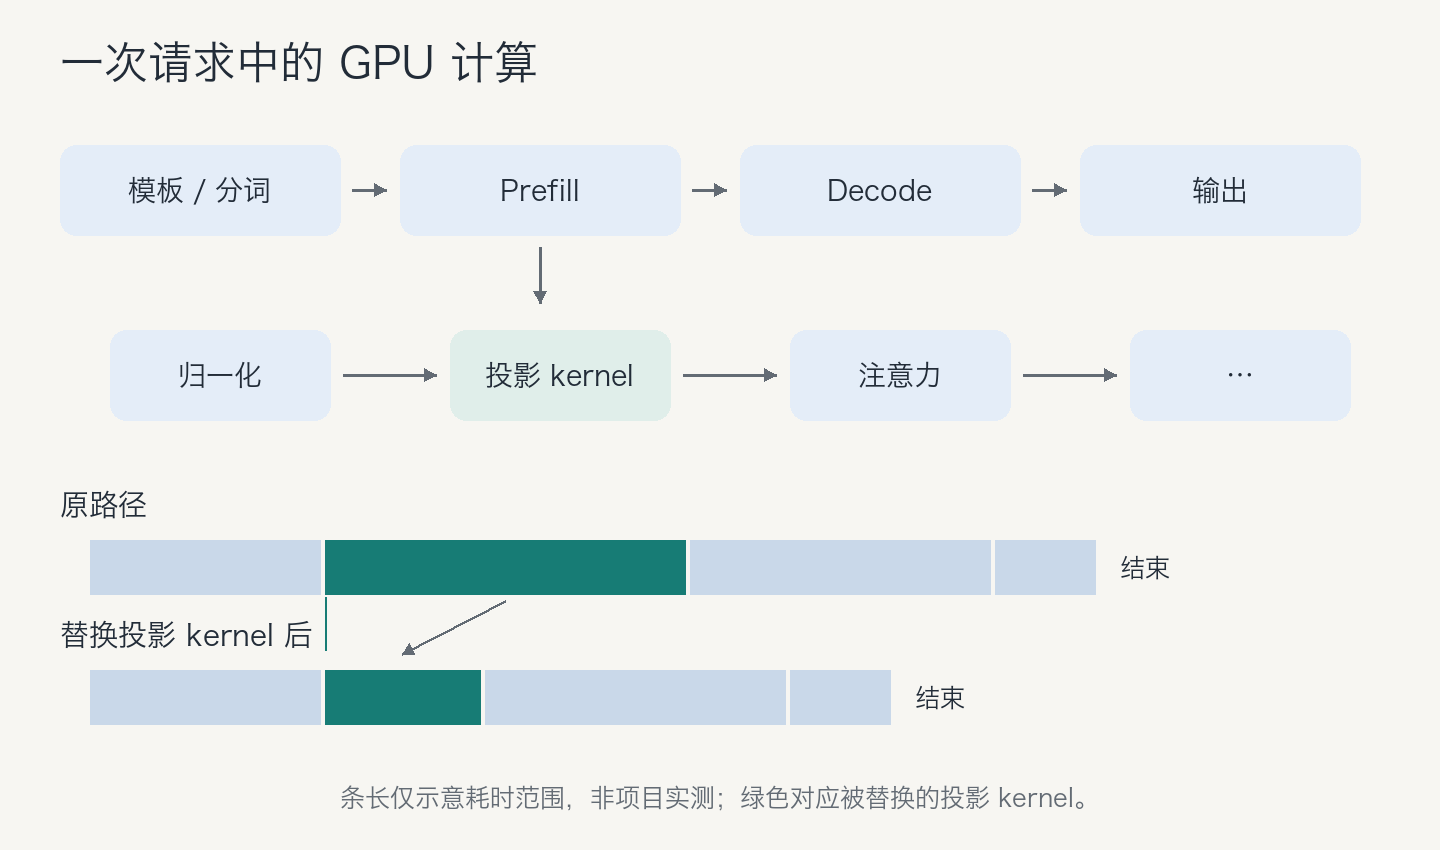
图中数字来自 qmt_on() 的测试注释;适用条件见 QMT 选择分支。阶段耗时可对照 Engine::chat 的统计,分别比较 prefill 和 decode。
2. 分块改变求和顺序,可能产生数值差异
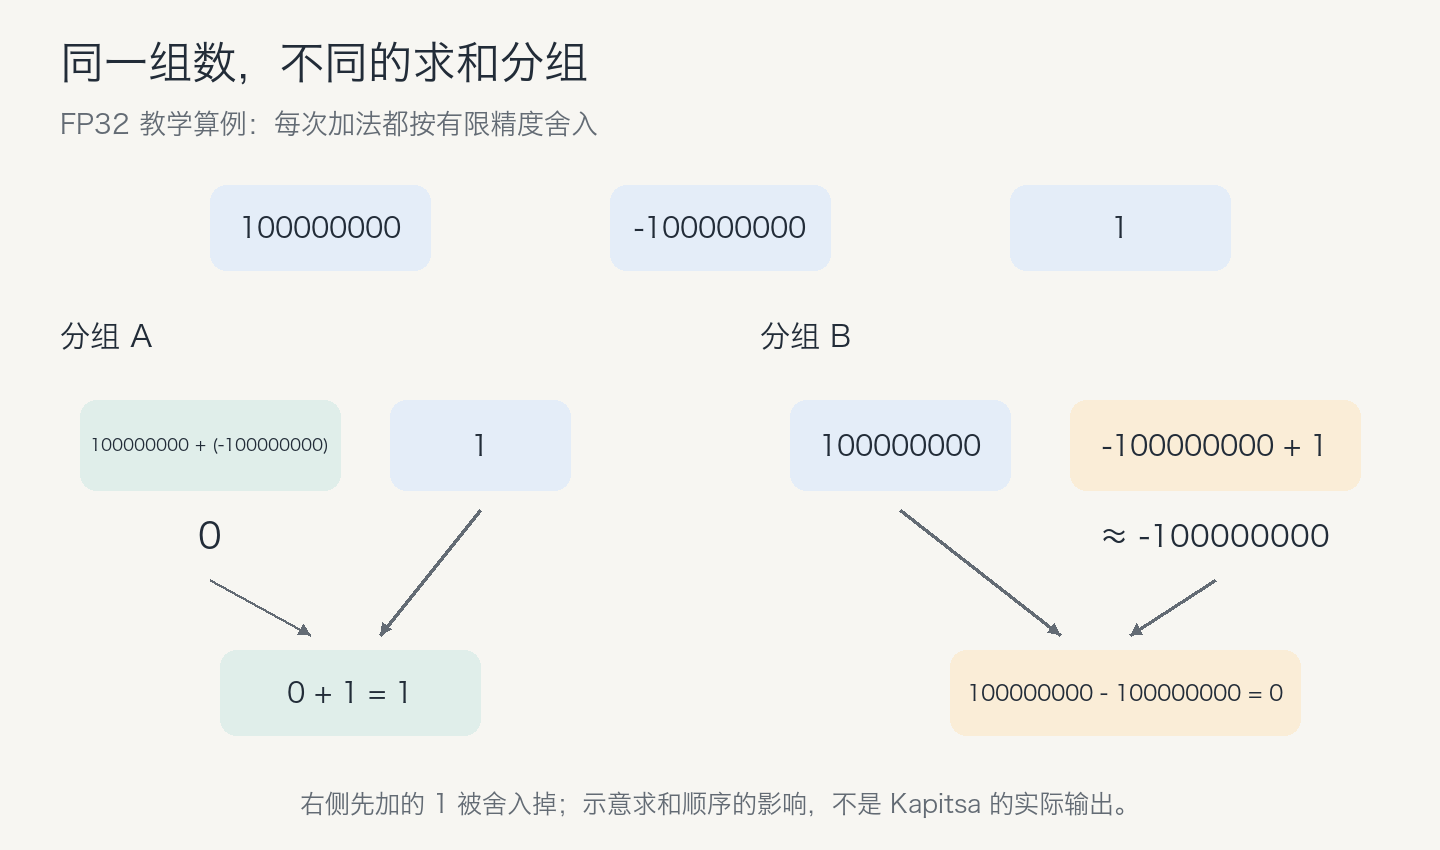
矩阵乘法的每个输出都是一串乘积的求和。GPU 分块和线程分工改变后,可能先分别累加几个小块,再汇总;另一条路径则按不同顺序累加。浮点数精度有限,每次加法都可能舍入,所以数学上等价的求和顺序,计算出的最后几位不一定相同。
这份代码有具体例子:QMT prefill 的实现说明 指出,部分 tensor-op 路径与原 simdgroup 路径采用不同的 K 维归约顺序,结果不保证逐位相同;其中的 expert tile 使用 tools/logit_compare.py --reorder 进行数值比较。这里需要检查的是差异大小及其对模型输出的影响,不能只看速度,也不能把“不是逐位相同”直接当作计算错误。
因此,验证一次 kernel 优化要同时报告相同模型、输入与设置下的阶段或请求耗时,以及与参考路径的数值差异。这样才能说明它加速了什么,又带来了怎样的结果变化。